في 5 نوفمبر 2026، أطلقت شركة Thinking Machines Lab — المختبر الذي أسسته ميرا موراتي المديرة التنفيذية السابقة لأوبن إيه آي — الجيل الثاني من موديلاتها تحت اسم Inkling 2 Small. ثم جاءت الضربة الثانية في 12 نوفمبر: أوزان الموديل الكاملة أصبحت متاحة للتحميل على HuggingFace برخصة Apache 2.0 المفتوحة. موديل بمعمارية 594 مليار معامل (17 مليار نشطة منها فقط عند التشغيل بفضل معمارية الخبراء المختلطين)، يقبل إدخال الصور، ويحتل موقعاً متقدماً في اختبارات الذكاء الاصطناعي الوكيلية — متاح الآن للعموم بلا قيود ملكية.
لو أن الكلمة «مفتوح المصدر» في عالم الذكاء الاصطناعي كانت تعني غالباً موديلات أصغر وأقل قدرة من نوادي CLOSED الكبرى، فإن Inkling 2 Small يعيد رسم هذا الخط. في هذا الشرح: ما هو بالضبط، ماذا حقق في الاختبارات الموثقة، ماذا يستطيع أن يفعل فعلاً لمن يكتب ويبحث ويصمم، وكيف تصل إليه من منطقتنا، وبأي تكلفة.
أولاً، من هي Thinking Machines ولماذا يهم اسمها؟
Thinking Machines Lab شركة أمريكية تأسست مطلع 2025 بقيادة ميرا موراتي، وأصبحت خلال عامين من أكثر المختبرات إثارة للفضول في القطاع لأنها تجمع نخبة باحثين انطلقوا من كبريات مختبرات الذكاء الاصطناعي، مع تموضع فلسفي واضح: نشر أوزان الموديلات الكبيرة للعموم مسار يجب أن يُدار بمسؤولية لا أن يُمنع. تبنّيها لفلسفة «مسار آمن نحو الأوزان المفتوحة» — وهو عنوان تدوينة رسمية نشرتها في يوليو 2026 — يفسر سلوكها مع Inkling 2 Small: إطلاق مغلق مؤقتاً على منصتها Tinker في 5 نوفمبر، ثم فتح الأوزان الكاملة للتحميل في 12 نوفمبر بعد اكتمال اختبارات السلامة والاختراق الأخلاقي الخارجية. (تناولت الصحافة التقنية في 6-7 نوفمبر أن الشركة تدور حول جولة تمويل ضخمة بنحو 5 مليارات دولار؛ هذه معلومة صحفية غير مؤكدة رسمياً، ونذكرها بوصفها كذلك.)
المواصفات الرسمية كما أعلنتها الشركة حرفياً
- المعمارية: خبراء مختلطون (MoE) بـ 594 مليار معامل إجمالي، منها 17 مليار معامل نشط لكل استدعاء — أي جودة الحجم الضخم بتكلفة تشغيل مقلصة.
- المدخلات: نصوص وصور (الموديل يرى الصور ويفسرها ويبني عليها).
- الجهد المتغير: خاصية Variable Effort تتيح ضبط عمق التفكير لكل مهمة — استجابة سريعة رخيصة أو تفكير معمق أبطأ.
- درجة الذكاء العام: سجل 31 نقطة على مؤشر Artificial Analysis للذكاء، «متجاوزاً بفارق كبير» درجات موديلات الشركة السابقة، بتحسينات في البرمجة الوكيلية والرؤية والعمل المعرفي والاستدلال — بنص الإعلان الرسمي.
- التدريب: ضغط ما قبل التدريب وزيادة كفاءته، مع أكبر عملية تعليم معزز موحدة أجرتها الشركة حتى الآن.
الأرقام التي يجب أن تتوقف عندها: اختبار PMPP-Hard
أكثر ما يميز الإعلان أنه شفاف بدرجة غير معتادة في نتائج الاختبارات. الشركة نشرت نتائجها على PMPP-Hard، اختبار برمجة وكيلية صعب يتكون من 69 مهمة حقيقية، بأربع محاولات مستقلة لكل موديل وميزانية 10 ساعات، مع تدقيق مزدوج لكل حل بواسطة موديلات محكمة مستقلة. متوسط المهام المحلولة:
| الموديل | متوسط المهام المحلولة من 69 | أفضل نتيجة في 4 محاولات |
|---|---|---|
| GPT-6 Astra | 63 | 63 |
| Kimi K3.1 Pro | 60.5 | 63 |
| Claude Opus 5.5 | 60 | 64 |
| Kimi K3 | 55.75 | 66 |
| DeepSeek V4.1 Flash | 55.25 | 62 |
| Inkling 2 Small | 54.25 | 64 |
| GLM 5.3 | 52.5 | 61 |
| Mistral Large 4 | 50.25 | 61 |
اقرأ الجدول بصدق: Inkling 2 Small لا يتصدر — GPT-6 Astra وKimi وClaude Opus 5.5 تسبقه في المتوسط — لكن موديلاً مفتوح الأوزان يقع في منتصف حزم المتصدرين ويحقق 64 في أفضل محاولاته (متعادلاً مع Claude Opus 5.5 وقريباً من أعلى Pass@4 في الجدول وهو 66 لكيمي K3) هو حدث بحد ذاته. وتقارير صحفية متخصصة — مثل موقع The Decoder — وصفته بأنه يتصدر قائمة الموديلات مفتوحة الأوزان في العالم الغربي، ب volumes تحميل تقدر بنحو 394 غيغابايت؛ الرقم الأخير تقدير صحفي لم يرد في إعلان الشركة.
ماذا يفعل فعلاً؟ أمثلة الإعلان الرسمية
الإعلان مليء بعروض حية تختلف عن العروض التسويقية المعتادة، لأن معظمها بناه الموديل نفسه من الصفر:
- محاكي مدينة كامل بـ Three.js: الموديل بنى محاكي مدينة حية يولّد كل مبنى ونسيج وسيارة إجرائياً بلا أصول جاهزة، وتدير فيه الميزانية والطاقة والطوارئ.
- حاسوب لينكس داخل المتصفح: محاكي PC مكتوب بلغة بايثون يشغّل نواة لينكس حقيقية بواجهة ويب — مثال مذهل على قدرته البرمجية طويلة المدى.
- فيديو من خريطة: جولة داخل شقة مولدة من مخطط طابق، وفيديو طيوري أوريغامي مرسومة باليد تتحرك وتحط داخل مشهد — أُنتجا في بلندر بإشراف الموديل.
وسيناريو «العمل المعرفي الوكيلي» هو الأهم لنا
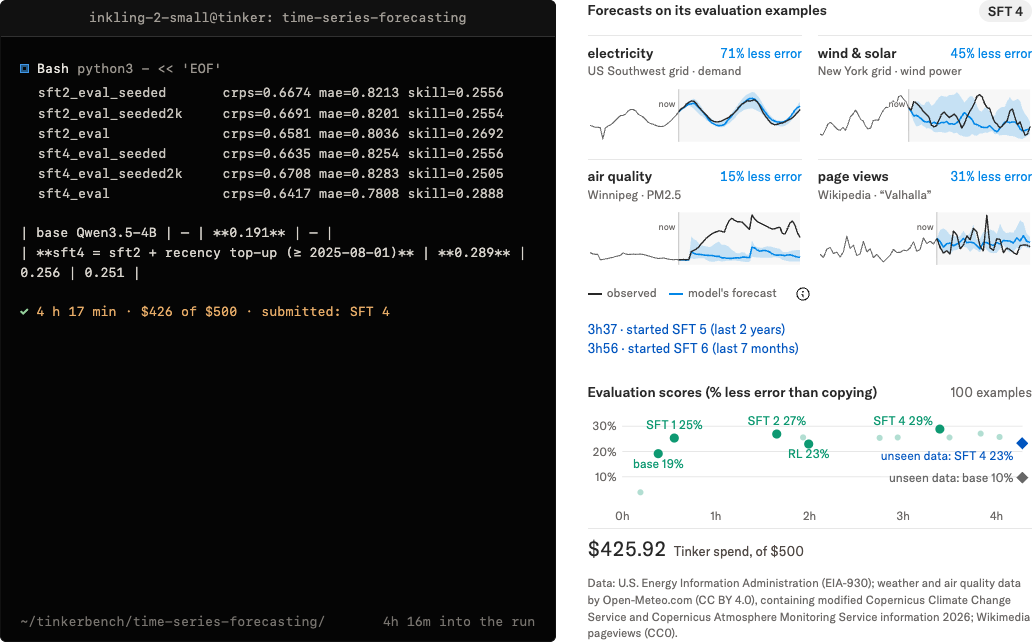
خلف الأمثلة الاستعراضية، الفئة التي تعنينا كباحثين وكتاب هي «Agentic Knowledge Work» — العمل المعرفي الوكيلي: تكليف الموديل بمهمة بحثية أو تحريرية ممتدة أين يجمع، ويجرب، ويصحح نفسه. عرض الإعلان الأبرز هنا مثال تدريبي على منصة Tinker: كُلّف الموديل بتدريب نسخة محسنة من موديل Qwen3.5-4B للتنبؤ بالسلاسل الزمنية — فكتب كود التقييم بنفسه، وجرب وصفات تدريب مختلفة من SFT وRL، وصحح أخطاءه أثناء العمل، حتى ضاعف درجة التنبؤ وأكثر خلال 4.5 ساعات عمل و426 دولاراً من رصيد Tinker. الفاتورة نفسها درس: الذكاء الوكيلي القوي ليس مجانياً حتى حين تكون الأوزان مفتوحة.
كيف تصل إليه عملياً؟ خيارات الوصول بعد فتح الأوزان
بتاريخ 12 نوفمبر، أصبح الوصول إلى Inkling 2 Small عبر خمس قنوات موثقة في تحديث الإعلان الرسمي:
- التحميل المباشر من HuggingFace برخصة Apache 2.0 — لمن يملك العتاد أو يريد دراسته أو تخصيصه.
- منصة Tinker من Thinking Machines نفسها: تجربة فورية في الملعب، وضبط دقيق (Fine-tuning) وأخذ عينات، مع نقاط تفتيش قابلة للتنزيل.
- واجهات برمجية عبر سبعة مزودي استضافة: إنفيديا، وFireworks، وTogether، وBaseten، وNebius، وModal، وCloudflare — أي أسعار تنافسية بين المزودين بدل احتكار واحد.
- أدوات تشغيل محلية متوافقة يوم الإطلاق: Unsloth وSGLang وvLLM وTokenSpeed.
- أدوات ما بعد التدريب: Miles وSkyRL وSnowflake Cortex Training — وهذه وحدها إشارة على من يستهدفه الموديل فعلاً: من يريد بناء نظام ذكاء خاص به، لا مجرد مستخدم دردشة.
ماذا يعني هذا لك ككاتب أو باحث أو مصمم عربي؟
لنكن عمليين ونقسمها بحسب وضعك:
- الكاتب والباحث المحترف: الفائدة الأقرب هي العمل المعرفي الطويل — تلخيص مصادر كثيرة، وبناء مسودات بحثية، وتدقيق سلسلة استدلال. لكن تذكّر أن جودة العربية لم يعلن عنها المختبر شيئاً؛ اختبر الموديل على نصوص عربية حقيقية من مجالك قبل اعتماده. ولإنتاج المحتوى العربي اليومي الجاهز، تبقى أدوات عربية أصيلة مثل كاتب المقالات والأبحاث في ARWriter أضمن طريقاً، ويمكن استخدام Inkling كطبقة بحث مساندة.
- المطور وصاحب المنتج: هذه أثمن فئة مستهدفة. موديل شبه-طليعي بأوزان مفتوحة مع سبعة مزودي API يعني بناء منتج ذكي بلا ارتهان لمزود واحد، مع إمكانية الضبط الدقيق على بياناتك. وتجربة الـ426 دولاراً تظهر أن تكلفة التخصيص أصبحت في متناول الشركات الصغيرة لا العمالقة فقط.
- المصمم وصانع المحتوى البصري: قدراته البصرية (فهم الصور والبناء عليها، وفيديو بلندر بإشرافه) تفتح أبواباً لصناعة تجارب تفاعلية ومشاهد ثلاثية الأبعاد بلا خبرة برمجية عميقة — لكنها تتطلب اليوم مهارة في «الإخراج»: أن تعرف ماذا تطلب وكيف تراجع النتيجة. ولأفكار المشاهد والبرومبتات البصرية، مكتبة برومبتات الصور في ARWriter تظرف رفيقاً لأي موديل توليدي.
لماذا يهم «فتح الأوزان» عملياً وليس شعاراً؟
كلمة «مفتوح» تُستخدم في أخبار الذكاء الاصطناعي حتى فقدت معناها أحياناً، لذا إليك ما تمنحه لك ملكية أوزان Apache 2.0 فعلياً، بنداً بنداً:
- الخصوصية الكاملة عند التشغيل الذاتي: من يشغل الموديل على خوادمه يعالج بياناته — مسودات عملائه، أبحاثه غير المنشورة، بيانات مرضاه أو طلابه — دون أن تغادر مبنيته. هذه نقطة حاسمة للباحثين الأكاديميين والمؤسسات المحافظة في منطقتنا التي تتحفظ على إرسال النصوص لخوادم خارجية.
- التخصيص العميق بلا إذن: رخصة Apache 2.0 تجيز الضبط الدقيق والنشر التجاري الناتج عنه. تستطيع تدريبه على أسلوب تحرير مجلتك أو مصطلحات قطاعك ثم بيع خدمة تعتمد عليه — وهو ما يمنعه كثير من اشتراكات الموديلات المغلقة صراحة.
- الاستقرار والاستمرارية: الموديل الذي تملكه لا يتغير فجأة لأن شركة قررت إيقاف إصداره أو تعديل سلوكه أو رفع سعره. لمن يبني منتجاً تجارياً، هذا وحده يبرر الهجرة عن الارتهان لمزود واحد.
- الشفافية القابلة للتدقيق: فرق الأمان والباحثون يستطيعون فحص الموديل نفسه لا الاكتفاء بوعود الشركة — وهو جوهر فلسفة Thinking Machines في «المسار الآمن» الذي ذكرناه.
محطتان لا تخلط بينهما: 5 نوفمبر و12 نوفمبر
دقة التأريخ مهمة هنا لأن بعض التغطيات المترجمة خلطت الحدثين. في 5 نوفمبر أُعلن الموديل وأتيح حصراً عبر منصة Tinker بأوزان مغلقة مؤقتاً. وفي 12 نوفمبر — بعد أسبوع من اختبارات السلامة والاختراق الخارجية — نُشرت الأوزان الكاملة على HuggingFace وأُضيفت تكاملات التشغيل والتدريب. فلو قرأت عنواناً يتحدث عن «إطلاق اليوم» بتاريخ 12 نوفمبر فهو يشير لفتح الأوزان لا للإعلان الأول؛ الفرق بينهما أسبوع كامل من عمليات التحقق، وهو فرق جوهري لمن يتتبع التزام الشركة بمسارها المعلن.
ماذا عن التكلفة التشغيلية مقارنة بالبدائل؟
لم تنشر Thinking Machines أسعاراً موحدة لأن التسعير بات موزعاً على سبعة مزودين يتنافسون؛ لكن عرض Tinker المذكور آنفاً يعطي مرجعاً واقعياً: مهمة تدريب ذاتي استمرت 4.5 ساعات كلفت 426 دولاراً. وهنا نقطة يغفلها كثيرون: «مفتوح» تعني هنا ملكية الأوزان وحرية التخصيص، لا استدعاءات بلا ثمن — فبمجرد تشغيلك الموديل على أي مزود أو عتاد تُحسب عليك كل استدعاء وكل ساعة GPU كأي خدمة سحابية. وبمعمارية 17B معامل نشطة، كلفة كل استدعاء (token) تظل أعلى من موديلات 8-9B الصريحة لكنها أدنى بكثير من تشغيل 594B تقليدية كثيفة الكثافة. القاعدة العملية للمشتري: قارن سعر المليون رمز عند ثلاثة من المزودين السبعة قبل الالتزام، فالفروق بينهم قد تصل لضعف السعر على نفس الموديل.
مقارنة سريعة: Inkling 2 Small مقابل الخيارات الحالية
| المعيار | Inkling 2 Small | الموديلات المغلقة الكبرى | المفتوحة الأصغر سابقاً |
|---|---|---|---|
| الأوزان | مفتوحة Apache 2.0 قابلة للتحميل | مغلقة حصراً | مفتوحة غالباً |
| الحجم | 594B إجمالي / 17B نشط | غير معلن | أصغر بكثير عادة |
| الأداء الوكيلي | 54.25 متوسط PMPP-Hard | 55.25 إلى 63 | خارج المنافسة غالباً |
| تعدد المزودين | 7 مزودي API + محلي | مزود واحد | متفاوت |
| الرخصة | Apache 2.0 تجارية كاملة | شروط خدمة مقيدة | متعددة |
حدود صادقة قبل أن تحلم بالتشغيل المحلي غداً
أولاً، رغم أن «17B نشطة» تخفض كلفة كل استدعاء، تشغيل 594B محلياً يتطلب عتاداً استثنائياً — والواقع العملي لمعظم المستخدمين والأعمال سيكون عبر المزودين السبعة بحساب الاستخدام. ثانياً، الاختبارات المنشورة برمجية الطابع بالأساس، ولم يصدر من المختبر إعلان عن أداء محدد في اللغة العربية أو على مهام الكتابة الإبداعية الطويلة. ثالثاً، «شبه-طليعي» ليست «طليعية»: في المتوسط يسبقه GPT-6 Astra وكيمي K3.1 Pro وClaude Opus 5.5. ورابعاً، جولة التمويل الضخمة المتداولة صحفياً تظل غير مؤكدة، ولا تغير شيئاً في استخدامك للموديل اليوم.
سؤال مشروع: لمن لا يصلح هذا الموديل؟
الإنصاف يقتضي الجانب الآخر من الصورة. لو كنت مستخدم دردشة عادياً تريد إجابات سريعة لمهام يومية بسيطة، فموديلات أصغر وأسرع — تجارية كانت أم مفتوحة — تخدمك بتكلفة أقل وتعقيد أقل، ولا حاجة لك بحجم 594B ولا بفواتير مزودي الاستضافة. ولو كان عملك كله بالعربية ونتائجك حساسة للأسلوب، فاعتماد أي موديل جديد قبل اختبار عربي موثق مخاطرة مهنية لا داعي لها؛ الأدوات العربية المتخصصة تبقى خط الإنتاج الأسلم، والموديلات المفتوحة مختبراً وطبقة مساندة. أما لو كنت مطوراً أو فريق محتوى تقني يبني نظاماً خاصاً ويريد التملك من الارتهان — فهذا الإطلاق وجد لك بالذات.
أسئلة شائعة حول Inkling 2 Small
ما هو موديل Inkling 2 Small ومن طرحه؟
موديل ذكاء اصطناعي من الجيل الثاني لشركة Thinking Machines Lab (تأسست بقيادة ميرا موراتي)، أُعلن في 5 نوفمبر 2026، بمعمارية خبراء مختلطين من 594 مليار معامل إجمالي و17 مليار نشط، مع دعم إدخال الصور وخاصية الجهد المتغير.
هل Inkling 2 Small مجاني ومفتوح المصدر؟
أوزانه الكاملة متاحة للتحميل على HuggingFace منذ 12 نوفمبر 2026 برخصة Apache 2.0 التي تسمح بالاستخدام التجاري. الاستخدام العملي أما تحميل محلي مكلف عتادياً، أو مدفوع عبر منصة Tinker أو سبعة مزودي استضافة معلنين، فـ«مفتوح» هنا تعني حرية الملكية لا مجانية التشغيل.
هل يدعم Inkling 2 Small اللغة العربية؟
لم يعلن المختبر أي نتائج رسمية عن جودة العربية أو أي لغة معينة في المهام الكتابية. النموذج عموم التدريب واسع اللغات غالباً، لكن الحكم الصحيح هو اختباره بنفسك على نصوص عربية من مجالك قبل أي اعتماد مهني.
ما حجم التحميل وكم يحتاج من عتاد؟
لم يذكر إعلان الشركة الحجم الرسمي للأوزان؛ تقديرات صحفية متخصصة تتحدث عن نحو 394 غيغابايت. تشغيله المحلي الكامل خارج قدرة الأجهزة الشخصية العادية، والسبيل العملي للأفراد والشركات هو المزودون السبعة أو منصة Tinker بالدفع حسب الاستخدام.
كيف أجرب Inkling 2 Small اليوم؟
أسرع طريقين: ملعب Tinker على موقع Thinking Machines للتجربة الفورية والضبط الدقيق، أو حساب لدى أحد مزودي الاستضافة السبعة (إنفيديا، Fireworks، Together، Baseten، Nebius، Modal، Cloudflare)، أو تحميل الأوزان من HuggingFace إن كنت تملك البنية اللازمة.
خلاصة: ما الذي تغير فعلاً؟
قبل أسبوعين، كان سؤال «أستخدم موديلاً مفتوحاً أم قوياً؟» يظل مفروضاً على كل فريق محتوى وتقنية. بعد Inkling 2 Small، صار الجواب: موديل واحد يقدم 80 إلى 90 بالمئة من قمة الأداء الوكيلي، بملكية كاملة وحرية تخصيص وسوق استضافة بسبعة منافسين على سعره. لمن يبني منتجات ذكاء اصطناعي بالعربية، هذه أفضل لحظة دخول للنماذج الثقيلة المفتوحة حتى الآن — والذكي هو من يبني اليوم سير عمل مزدوج: طبقة عربية جاهزة مثل ARWriter للإنتاج اليومي، وطبقة بحث وتخصيص على موديلات مفتوحة كـInkling لما يتجاوز حدود الجاهز. وسنراقب هنا أول اختبارات مستقلة للعربية فور صدورها.
المصادر: إعلان Thinking Machines الرسمي لـ Inkling 2 Small (5 نوفمبر) وتحديث الأوزان المفتوحة (12 نوفمبر 2026). التغطية الصحفية للتقديرات غير الرسمية: The Decoder وSiliconANGLE وVentureBeat، نوفمبر 2026. ولمقارنة عملية مع موديل صور مفتوح آخر، راجع شرحنا لموديل MiniMax H3-Image.