آخر تحديث: 20 سبتمبر 2026 — تغطية معمّقة لحدث 10 سبتمبر 2026
في 10 سبتمبر 2026 أعلنت OpenAI إتاحة موديل GPT-Live-1 لواجهاتها البرمجية، وهو النموذج الصوتي الذي كان حصرياً داخل ChatGPT طوال الفترة الماضية، والذي ينقل تطبيقات الصوت من نمط «تكلّم ثم انتظر الرد» إلى محادثة حقيقية متزامنة يسمع فيها الموديل ويتحدث في اللحظة نفسها. الإعلان ليس تفصيلاً تقنياً عابراً: فهو يفتح الباب أمام أي صاحب متجر أو صانع محتوى أو مطوّر عربي لبناء مساعد صوتي طبيعي بسعر معلن هو 0.05 دولار عن كل دقيقة لطبقة الصوت. في هذا الدليل المعمّق نفكّك الإعلان الرسمي بالكامل: ما الذي يميز الموديل معماريًا، وما الأرقام الموثقة، وكيف تحسب تكلفتك الحقيقية، وماذا يعني ذلك عمليًا لمن يصنع المحتوى بالعربية.
GPT-Live-1: ما هو ولماذا يختلف جذرياً عن حلول الصوت السابقة؟
معظم المساعدات الصوتية التي استخدمتها حتى اليوم — سواء داخل تطبيقات خدمة العملاء أو أدوات المنتجات — مبنية على سلسلة من ثلاث مراحل منفصلة: نظام يحوّل كلامك إلى نص، ثم موديل نصي يفهم ويرد، ثم نظام ثالث يحوّل الرد إلى صوت. كل انتقال بين هذه المراحل يضيف تأخيراً ويفقد جزءاً من إيقاع المحادثة الطبيعي، وعندما تقاطع المتحدث أو تسكت فجأة تنهار التجربة لأن السلسلة لم تُصمم للاستماع والكلام في وقت واحد.
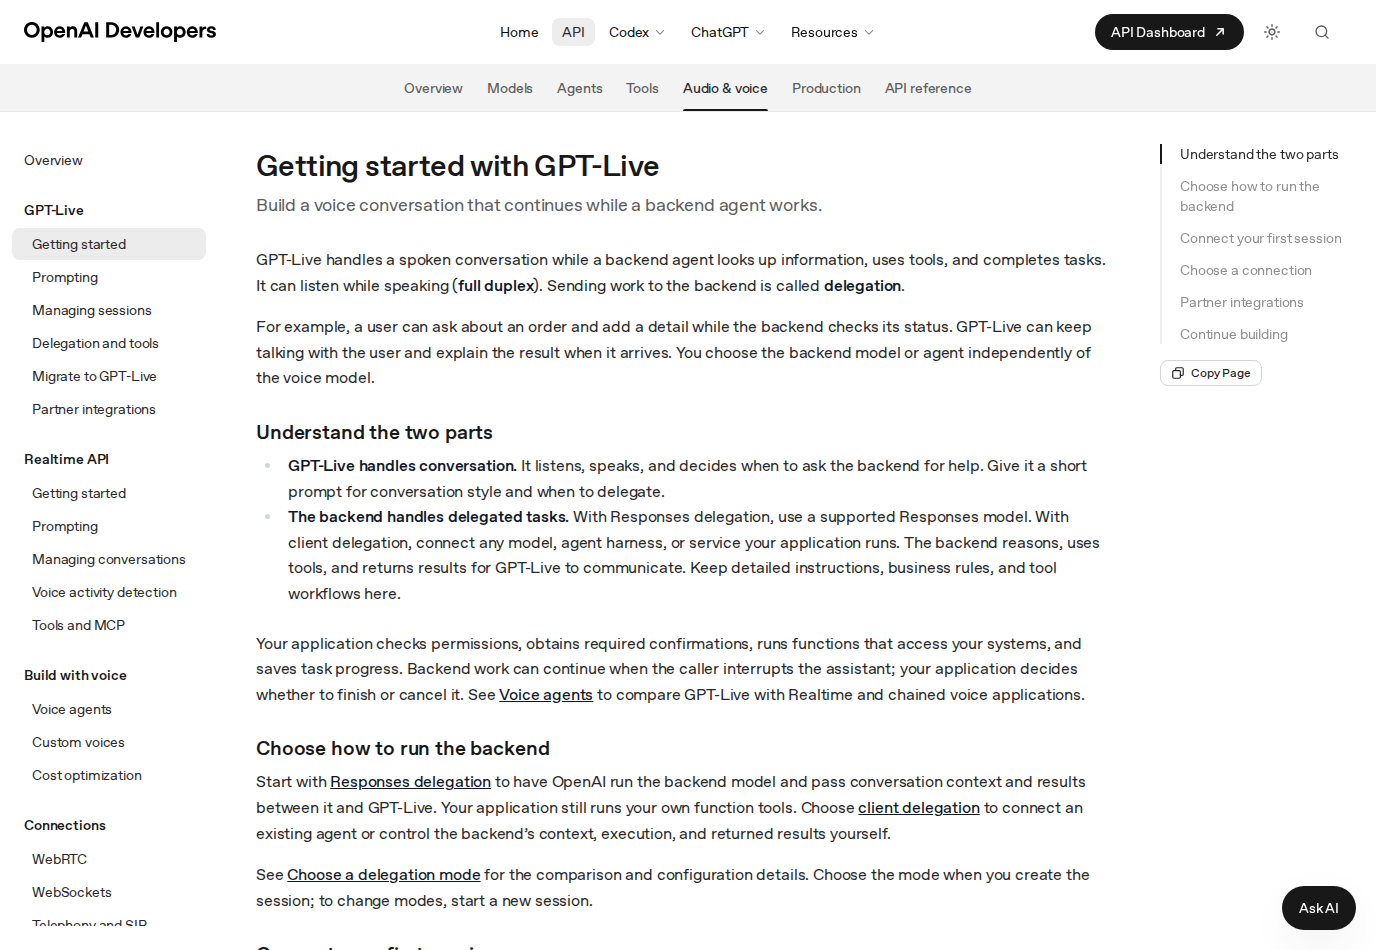
GPT-Live-1 يلغي هذه السلسلة من جذورها. الإعلان الرسمي يوضح أن الموديل يفسّر الصوت الوارد والصوت الصادر معاً في نموذج واحد، أي أنه يستمع إليك وهو يتحدث في اللحظة نفسها، ويتعامل مع المقاطعة والتعليقات القصيرة («أهوو»، «تمام»، ضحكة) كما يفعل إنسان حقيقي. وإذا احتاج الموديل إلى تفكير عميق أو استدعاء أداة خارجية، فإنه يفوّض ذلك إلى موديل نصي خلفي — مثل GPT-6 Astra أو أي موديل آخر تختاره — وتستمر المحادثة الصوتية أثناء إنجاز العمل في الخلفية.
بعبارة أبسط: صار لديك «طبقة صوت» ذكية واحدة تُركّب فوق أي عقل تفكيري تريده. هذا الفصل بين الصوت والتفكير هو أهم قرار معماري في الإعلان، وهو ما يجعل السعر منخفضاً نسبياً: فأنت تدفع للطبقة الصوتية سعراً ثابتاً، وتختار بنفسك كلفة طبقة التفكير حسب المهمة.
القدرات الموثقة في الإعلان الرسمي
من واقع نص الإعلان على موقع OpenAI، هذه القدرات المعلنة حرفياً:
- معالجة المقاطعات بسلاسة: موديل واحد يفهم الصوت الداخل والخارج معاً، بلا انتظار أو تعارض بين الأنظمة.
- تفويض التفكير واستدعاء الأدوات: يمكن للموديل تسليم المهام المعقدة لموديل خلفي مثل GPT-6 Astra أو حتى موديل من طرف ثالث.
- التحكم في النبرة والإيقاع والأسلوب: عبر التعليمات النظامية تحدد هل مساعدك هادئ وسريع أم دافئ ومتمهل.
- إدارة الضجيج والصمت: يتعامل مع الضوضاء المحيطة وفترات السكوت دون أن يعلّق كل خطوة بصوت عالٍ.
- موثوقية الجلسات الطويلة: يحافظ على السياق وجودة الحوار عبر تفاعلات ممتدة.
- دعم الهاتف (Telephony): يمكن نشر وكلاء صوتيين كاملي التزامن على المكالمات الهاتفية، من حجز مطعم إلى دعم عملاء.
- تفريغ مدمج: يولّد نص المحادثة والردود نصياً بشكل أصلي، مع فهم قوي للأرقام والحروف المختلطة وإمكانية تفضيل كلمات مفتاحية معينة.
- كشف الأدوار: رغم أنه ليس موديلاً بالأدوار، إلا أنه يدعم كشف نهاية الدور نطقاً، لتتمكن من بناء منطق التناوب إن احتجته.
الأرقام الرسمية: ماذا تقول المقاييس؟
الإعلان يحمل رقمين بارزين يستحقان التوقف أمامهما:
- مقياس Full Duplex Bench: تحسّن بـ30 نقطة مئوية مقارنة بالجيل السابق GPT-Realtime-2.1، مع مكاسب كبيرة في زمن استلام الدور والسلوك التفاعلي.
- مقياس Tau3: مع GPT-6 Astra بمستوى تفكير متوسط، يحتل الموديل المركز الأول في مقياس يقيس ذكاء وكلاء الصوت في مهام شاملة من البداية للنهاية.
وربط الإعلان هذه الأرقام بنتائج ميدانية مبكرة: منصة تعليم اللغات Speak وجدت أن الموديل منح المتعلمين وقتاً أطول للتفكير قبل الرد، ما قلّل المقاطعات بنحو 80% مقارنة بأنظمة الأدوار السابقة. وهذه النقطة تحديداً — احترام صمت المستخدم — هي ما كان يفتقدبالضبط في معظم بوتات الصوت العربية الحالية.
12 صوتاً جديداً: ماذا عن العربية؟
مع الإطلاق وسّعت OpenAI مكتبة الأصوات الفورية إلى 12 صوتاً بأسماء: Quartz وRipple وVesper وWillow وStone وGleam وMeridian وBossa وTempo وBeacon وDelta وCinder، موزعة على لهجات وإنجيزيات مختلفة (فمثلاً Quartz بلهجة إنجليزية أسترالية). الإعلان يذكر حرفياً أن الشركة «ستواصل توسيع خيارات الأصوات وتوافر اللغات على مدار الأشهر القادمة».
ماذا يعني هذا للعربي؟ بصراحة: الإعلان لا يذكر العربية بالاسم بين اللغات المتاحة اليوم، والاستخدام العربي المباشر للأصوات الجديدة يحتاج تجربة عملية للتأكد من جودة النطق. من يريد بناء مساعد عربي الآن عليه اختبار عينة حقيقية عبر الواجهة قبل الالتزام، وهذا ما ننصح به دائماً: عيّنة أولاً ثم توسّع.
التسعير: كيف تحسب تكلفتك الفعلية؟
الرقم المعلن: 0.05 دولار عن كل دقيقة لطبقة الصوت الأمامية. لكن الفهم الصحيح للتكلفة يتطلب جمع طبقتين:
- طبقة الصوت (GPT-Live-1): 0.05 دولار/دقيقة — أي 3 دولارات عن ساعة محادثة كاملة.
- طبقة التفكير الخلفية: تُحتسب بسعر الموديل الذي تختاره (مثل GPT-6 Astra أو موديل أرخص للمهام البسيطة)، لأن الإعلان يتيح «مطابقة عمق التفكير والسرعة والتكلفة مع كل مهمة».
عملياً، لمساعد يستخدم موديلاً خلفياً اقتصادياً للمهام المتكررة (حالة طلب، موعد)، يمكن أن تبقى ساعة التفاعل الكاملة ضمن نطاق الدولارات القليلة — وهو رقم يجعل بوت الصوت ممكناً لمتجر صغير أو صانع محتوى فردي، بينما كان قبل عامين حكراً على الشركات. ولمن يريد أصواتاً مخصصة بالكامل، الإعلان يحوّل ذلك إلى مسار مبيعات مباشر مع OpenAI.
ماذا يعني هذا لك كصانع محتوى عربي؟
لنبقِ في أرض الواقع: GPT-Live-1 منتج للمطورين عبر الواجهة البرمجية، وليس زراً تضغطه داخل ChatGPT. لكن أثره على سير عملك مباشر في خمسة مسارات:
- بوت صوتي لمتجرك أو خدماتك: الطلبات عبر واتساب والهاتف هي أسرع قناة تحويل في السوق العربي؛ بموديل واحد بدل ثلاثة أنظمة تنخفض كلفة البناء والصيانة بشكل حقيقي، ودفعة Yelp الرسمية تظهر أن المكالمات الهاتفية صارت مساراً جاهزاً.
- محتوى تفاعلي مباشر: بث مباشر أو فيديو تفاعلي يرد على المشاهدين صوتياً في الوقت الحقيقي — صار قابلاً للتنفيذ دون فريق هندسي كبير.
- بودكاست ومحتوى صوتي: استخدام الموديل كمساعد تسجيل وتحسين للحوار، خصوصاً مع التحكم في النبرة والإيقاع عبر التعليمات.
- دروس ومحتوى تعليمي: النموذج يمنح المتعلم مساحة تفكير بدل مقاطعته — وهي ميزة تعليمية موثقة من تجربة Speak.
- أدوات داخلية تختصر يومك: مساعد يجيب عن أسئلة فريقك صوتياً أثناء عملك، مع تفويض الأسئلة المعقدة لموديل نصي.
وتذكّر أن مشهد الصوت العربي يتحرك بسرعة من كل الاتجاهات: جوجل أطلقت Gemini 3.8 Live بمساعد يفكر ويتحدث معاً (غطّينا إطلاقه في هذا الدليل)، وعلي بابا دفعت بـQwen3.8-Omni-Flash بفهم صوتي وفيديو كما شرحنا سابقاً، وحتى نماذج التفريغ الصوتي قفزت بدقتها كما في موديل مايكروسوفت MAI Transcribe 2. القرار الذكي ليس «أي موديل أفضل» بل «أي طبقة صوت تناسب جمهورك وميزانيتك».
مقارنة سريعة: GPT-Live-1 مقابل البدائل المتاحة اليوم
| الوجه | GPT-Live-1 (OpenAI) | Grok Voice Agent API (xAI) | Gemini 3.8 Live (Google) | سلسلة STT+LLM+TTS تقليدية |
|---|---|---|---|---|
| المعمارية | موديل صوت واحد كامل التزامن | حزمة صوتية متكاملة من xAI | موديل Live مع تفكير موسع | ثلاثة أنظمة مترابطة |
| المقاطعة الطبيعية | نقطة القوة الأولى +30 نقطة على مقياس التزامن | موجودة عبر Voice Agent API | موجودة مع كشف تفكير | ضعيفة ومتأخرة |
| السعر المعلن | 0.05$/دقيقة للصوت + موديل خلفي منفصل | تسعير استهلاكي عبر console.x.ai | ضمن باقات Google AI | مجموعة فواتير من ثلاث خدمات |
| أفضل استخدام | وكلاء هاتف وتفاعل طبيعي غني | دعم متعدد اللغات وتكامل Tesla/X | مساعدات جوجل وGmail وDocs | حالات مخصصة جداً |
حدود وعيوب صادقة قبل أن تبني عليها
- واجهة برمجية فقط: لا يوجد منتج جاهز؛ تحتاج مطوراً أو أدوات no-code تسمح بالاتصال بالـ API.
- العربية غير مؤكدة الأداء: الإعلان لا يوثق مستوى العربية بين الأصوات واللغات الحالية؛ اختبر عينة قبل الالتزام.
- التكلفة تتراكم بالدقائق: خدمة تنجح وتستقبل آلاف الدقائق شهرياً ستدفع بالتزامن؛ خطط لسقف إنفاق واضح.
- جودة الدوران على الأرقام: رغم تحسن فهم الأرقام والحروف المختلطة، بيانات مثل أرقام الهواتف العربية تحتاج اختباراً ميدانياً في بيئتك.
- الاعتماد على مورّد واحد: تفويض التفكير مفتوح نظرياً لموديلات طرف ثالث، لكن طبقة الصوت نفسها مغلقة على بنية OpenAI.
شركات بدأت تستخدمه فعلاً
الإعلان رافق شهادات موثقة من أربعة عملاء: Yelp شهدت بتحسن معدلات إنجاز المكالمات في نظامي Host وHatch مع جمل أكمل وأكثر طبيعية من المتصلين؛ وSpeak وثقت انخفاض المقاطعات 80%؛ وFin (إنتركوم) وصفت التجربة بأنها «أوضح إشارة حتى الآن لوجهة الدعم الصوتي»؛ وCognition (صانعة Devin) قالت إن العمل مع مهندس ذكاء اصطناعي بدأ يشعر بالعمل مع زميل حقيقي. وهناك أيضاً شهادة من شركة صحية مذكورة في الإعلان: تبسيط قاعدة الكود بنسبة 80% وحذف 23 ألف سطر برمجي مقارنة ببنية الدمج السابقة.
كيف تبدأ عملياً في عشر دقائق؟
- أنشئ حساباً في بوابة مطوري OpenAI وتوجه لقسم Live.
- جرّب نموذج المحادثة التفاعلي المدمج في صفحة الإعلان نفسها (مقاطعة، ضحك، تغيير رأي وسط الكلام).
- اقرأ دليل البدء الرسمي في وثائق المطورين (رابطه في قائمة المصادر أدناه).
- ابدأ بحالة استخدام واحدة ضيقة: مكالمات حجز، أو أسئلة متكررة، ثم وسّع بعد قياس النتائج.
- حدد ميزانية تجريبية شهرية صغيرة وقس: نسبة إنجاز، زمن الرد، ورضا المستخدم.
نصيحة عملية من واقع تجارب الدمج المماثلة: ابدأ باللغة الإنجليزية لإثبات المفهوم إن كان جمهورك يتحمل ذلك، ثم أجرِ اختباراً موازياً بالعربية الفصحى المبسطة على عينة من عملائك الحقيقيين، وقارن النتائج قبل تعميم الخدمة. وثّق أخطاء التفريغ الشائعة (أسماء الأعلام، أرقام الهواتف، المصطلحات المحلية) وأضفها إلى قائمة الكلمات المفضلة التي يدعمها الموديل، فهذه الخطوة وحدها ترفع الجودة الملموسة بشكل ملحوظ في الأسابيع الأولى من التشغيل.
نظرة أعمق للدمج: كيف يتصل الموديل ببقية نظامك؟
الإعلان تضمّن مثالاً برمجياً رسمياً يوضح الفكرة العملية للتفويض: تطبيقك يمرر سياق المحادثة إلى نظام آخر — والمثال يستخدم حزمة Codex البرمجية — ثم يعيد الجواب النصي إلى GPT-Live-1 لينطقه صوتياً كتعليق داخل الجلسة. المعنى الهندسي المهم هنا أن طبقة الصوت لا تفرض عليك بنية معينة للتفكير: تستطيع توجيه الأسئلة البسيطة إلى موديل خفيف رخيص، والأسئلة المعقدة إلى GPT-6 Astra، أو حتى إلى نظامك الداخلي الخاص، كل ذلك داخل جلسة صوتية واحدة لا يشعر المستخدم فيها بأي انتقال بين المحركات.
وللمؤسسات التي لا تريد البناء من الصفر، أشارت OpenAI إلى منتج OpenAI Presence الذي يستخدم GPT-Live-1 لتشغيل تفاعلات صوتية حية: وكلاء يجيبون ويحلّون ويستخدمون أنظمة الشركة ويتخذون إجراءات معتمدة ويصعّدون للبشر عند الحاجة. وهو خيار عملي للفرق العربية التي تريد مساعداً صوتياً مؤسسياً دون فريق هندسة داخلي، مع العلم أن الوصول إليه يتم عبر مدير الحساب في OpenAI وليس باشتراك ذاتي مباشر.
لماذا هذا الإعلان مهم الآن تحديداً؟
سبتمبر 2026 شهر غير مسبوق في مسابقة الصوت: خلال أسابيع قليلة رأينا Google تتوسع بGemini 3.8 Live ومساعديها الصوتيين داخل Gmail وDocs، وxAI توسّع منظومة Grok Voice من وكلاء الصوت إلى نماذج التفريغ، وعلي بابا تطلق نموذجاً أومني يسمع ويرى في الوقت نفسه، والآن OpenAI تفتح طبقتها الصوتية للجميع بتسعير الدقيقة. الاتجاه واضح: الصوت يتحول من ميزة ترفيهية داخل التطبيقات إلى طبقة أساسية تُبنى عليها الخدمات، تماماً كما حدث للنصوص قبل عامين. ومن يبني خبرته الصوتية اليوم — ولو بتجربة صغيرة محدودة — سيسبق السوق بفارق تجربة كامل عندما يصل الصوت العربي إلى المستوى نفسه من النضج.
الأسئلة الشائعة
ما هو GPT-Live-1؟
نموذج صوتي كامل التزامن من OpenAI أُتيح للواجهات البرمجية في 10 سبتمبر 2026، يستمع ويتحدث في وقت واحد، ويستطيع تفويض التفكير العميق لموديل نصي خلفي مثل GPT-6 Astra، بسعر معلن 0.05 دولار عن كل دقيقة لطبقة الصوت.
كم تكلفة الدقيقة في GPT-Live-1؟
طبقة الصوت الأمامية 0.05 دولار عن كل دقيقة (3 دولارات للساعة)، وتضاف إليها كلفة الموديل الخلفي الذي تختاره للتفكير، لأن كل طبقة تُحتسب بشكل منفصل حسب الإعلان الرسمي.
هل يدعم GPT-Live-1 اللغة العربية؟
الإعلان يذكر توسيع الأصوات واللغات تدريجياً دون تسمية العربية صراحة بين المتاح اليوم؛ الأصوات الاثنا عشر المعلنة موصوفة بلهجات إنجليزية مختلفة، بينما وعدت OpenAI بمزيد من اللغات «على مدار الأشهر القادمة». ننصح باختبار عينة صوتية عربية عبر الواجهة قبل بناء أي خدمة كاملة عليها، لأن جودة النطق تختلف كثيراً بين اللغات واللهجات، وبين إصدار وآخر من النموذج نفسه.
ما الفرق بين GPT-Live-1 والوضع الصوتي في ChatGPT؟
الوضع الصوتي داخل ChatGPT منتج جاهز للمستخدم النهائي، بينما GPT-Live-1 في الـ API هو نفس التقنية مفتوحة للمطورين لبناء مساعديهم الصوتيين داخل تطبيقاتهم ومواقعهم وأنظمتهم الهاتفية. الفرق الجوهري في التحكم: عبر الواجهة تستطيع تخصيص النبرة والإيقاع والأسلوب، وربط الموديل بأدواتك وقواعد بياناتك، وتحديد موديل التفكير الخلفي لكل نوع أسئلة، بينما تجربة ChatGPT تبقى عامة لا يمكن برمجتها. كما أن الفوترة عبر الـ API تُدار حسب الاستهلاك الفعلي بالدقائق بدل الاشتراك الثابت.
هل يحتاج صانع المحتوى الفردي إلى فريق برمجة؟
لأي تكامل مخصص نعم، تحتاج مطوراً أو منصة no-code تدعم الـ API — وحتى مع منصات البناء الجاهزة ستحتاج فهم أساسيات الجلسات الصوتية والتعليمات النظامية. لكن إن كان هدفك الأساسي إنتاج محتوى مكتوب وتصميم وجدولة بالعربية فأدوات أقرب إليك مثل ArWriter تغطي ذلك كله دون سطر برمجي واحد، ويمكنك استعراض قائمة الأدوات الكاملة هنا قبل أن تقرر أين توجه وقتك.
المصادر
- إعلان OpenAI الرسمي: Build more natural voice experiences with GPT-Live-1 in the API — المصدر الأولي لكل الأرقام والتواريخ (10 سبتمبر 2026)
- وثائق مطوري OpenAI — دليل البدء مع GPT-Live-1
- تغطيات ArWriter السابقة: إطلاق GPT-6 Astra وGemini 3.8 Live لسياق مشهد الصوت والنماذج
مشهد الصوت يتغير شهرياً، لكن مبدأ عملك لا يتغير: جمهورك يقرأ ويشاهد بلغته. سواء بنيت مساعدك الصوتي أم لا، اجعل إنتاج المحتوى العربي نفسه هو الميزة التي لا يلحقك بها أحد — ابدأ من ArWriter واكتب وصمّم وجدول من مكان واحد.