استوديو أصوات كامل داخل متصفحك — وهذه المرة العربية في الواجهة
في الثاني والعشرين من سبتمبر 2026 أعلنت جوجل عن جاهزية نموذجين جديدين لتحويل النص إلى كلام ضمن عائلة جيميني: Gemini 3.8 Flash TTS للإنتاج الإبداعي عالي الجودة، وGemini 3.8 Flash-Lite TTS للأحجام الكبيرة والتكلفة الأقل، ثم跟进ت في اليوم التالي بمنشور تفصيلي على مدونتها الرسمية بعنوان «Gemini 3.8 text-to-speech says hello». الخلاصة التي تهمك كصانع محتوى عربي: لم تعد الأصوات الاصطناعية «قراءة آلية» للنص، بل صارت أداءً تمثيلياً تُخرجه أنت سطراً بسطر — والعربية الفصحى كانت ضمن اللغات التي تصدّرتها جوجل في تقييماتها العمياء على منافساتها.
هذا الدليل الشامل يجمع كل ما تحتاج معرفته من المصادر الرسمية مباشرة: ما الجديد فعلاً، كم تكلف الساعة الصوتية بالأرقام، كيف تجرب النماذج اليوم مجاناً في Google AI Studio، وما الحدود التي يجب أن تعرفها قبل أن تبني عليها خط إنتاجك القادم.
ما الذي أطلقته جوجل بالضبط؟
الإعلان ليس نموذجاً واحداً بل منظومة صوتية متكاملة من أربعة أجزاء مترابطة:
- Gemini 3.8 Flash TTS (
gemini-3.8-flash-tts): النموذج الرائد المبني للإخراج الإبداعي العميق وتصميم الشخصيات — كتب صوتية غامرة، بودكاست درامي، شخصيات ألعاب، وأداء تمثيلي بمزامنة كاملة. - Gemini 3.8 Flash-Lite TTS (
gemini-3.8-flash-lite-tts): النموذج السريع الاقتصادي، المخصص للدبلجة عالية الحجم وصناعة المحتوى الصوتي المتواصل ووكلاء الصوت الآليين، وهو البديل الرسمي لـgemini-3.1-flash-tts-preview. - نقطة النهاية الجديدة للأصوات (
/v1beta/voices): واجهة برمجية للاستعلام عن أكثر من 150 صوتاً جاهزاً ومخصصاً وإدارتها برمجياً. - ثلاث قدرات مرفقة: تصميم الأصوات من الصفر، واستنساخ الأصوات بموافقة موثقة، ومكتبة الأصوات الموسعة.
النموذجان متاحان اعتباراً من الإعلان للمطورين عبر Gemini API وGoogle AI Studio، ولمستخدمي Gemini Notebook (نموذج Flash الكامل) وGoogle Vids (نموذج Lite)، بينما وصفت جوجل وصولهما إلى Gemini Enterprise عبر الواجهة البرمجية بأنه «قريباً». وبهذا تكتمل عائلة Gemini Audio التي سبق أن رأينا منها هذا الشهر نموذجي Gemini 3.8 Live للمحادثة الصوتية الحية إلى جانب 3.5 Transcribe للتفريغ و3.5 Live Translate للترجمة الفورية.
العربية هذه المرة في الصدارة — وليست في ذيل القائمة
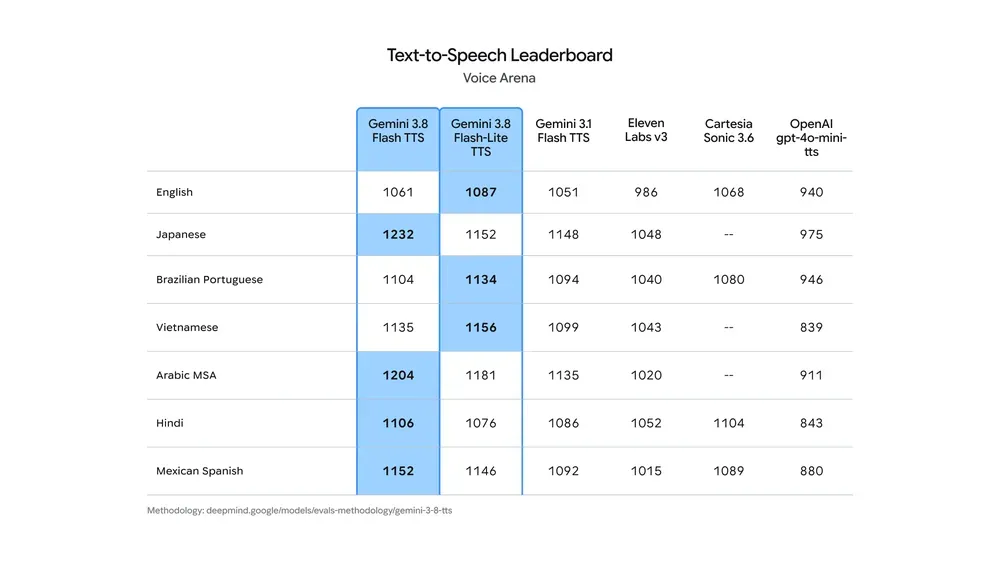
هذه هي النقطة التي تجعل الإعلان مهماً تحديداً للجمهور العربي، ولست أبالغ: في تقييمات التفضيل العمياء على منصة Voice Arena — حيث يستمع أشخاص حقيقيون إلى مقاطع متنافسة دون معرفة مصدرها — حقق النموذجان «مواقع ريادية بين المنافسين في لغات عالمية رئيسية» ضمت صراحةً العربية الفصحى الحديثة (MSA) إلى جانب اليابانية والبرتغالية البرازيلية والفيتنامية والإسبانية المكسيكية والهندية. أي أن الصوت العربي المولد من جيميني لم يكن «مدعوماً» فحسب، بل نافس على القمة مباشرة.
وثائق جوجل الرسمية تسرد في جدول اللغات كلاً من العربية المصرية والعربية الفصحى (بالخط العربي واللاتيني على السواء) مدعومةً بالكامل في النموذجين. ولمن يتذكر تجارب الأصوات العربية السابقة بلهجاتها المكسورة وأخطاء التشكيل، الفرق هذه المرة ليس تحسيناً تدريجياً بل انتقالاً إلى فئة أخرى كلياً: أصوات تُخرج نبرة الجملة وتتقن الوقف والتنغيم.
من 30 صوتاً جاهزاً إلى أكثر من 2000
قبل هذا الإصدار كان المطورون يختارون من نحو 30 صوتاً ثابتاً. الآن تتحدث جوجل عن أكثر من 2000 صوت جاهز للإنتاج بتغطية لغوية واسعة تشمل لهجات إقليمية محددة مثل الإسبانية المكسيكية والفرنسية الكيبيكية والإنجليزية الأسكتلندية — إشارة صريحة إلى أن التغطية تصل إلى مستوى اللهجات الفرعية وليس اللغات الكبرى فقط.
ولأن المكتبة الجاهزة مهما اتسعت لا تلبي هوية علامة تجارية مميزة، أضافت جوجل ثلاث أدوات لصنع أصواتك الخاصة:
- التصميم التوليدي للأصوات: تصف الصوت بجملة طبيعية («راوية خليجية هادئة بنبرة دافئة تصلح لقصص الأطفال») فيولد النموذج الشخصية الصوتية كاملة — الدور واللكنة والخصائص — عبر أكثر من 100 لغة ولهجة. الأمثلة الرسمية في إعلان جوجل تضمنت «دي جي مليء بالطاقة من ملبورن» و«روبوت رتيب رفيع الصوت» و«تنين ياباني».
- استنساخ الأصوات: تسجيل صوتي مدته 30 ثانية فقط من صوتك أو صوت تملك حقوق استخدامه يكفي لإعادة إنشاء شخصية صوتية متطابقة، مع نظام موافقة إلزامي: تسجيل موافقة صوتية من مالك الصوت يجب أن يتطابق مع المتحدث المرجعي قبل السماح بإنشاء النسخة.
- الحفظ والإدارة: تحفظ الأصوات التي صممتها لتعيد استخدامها عبر المشاريع بثبات ودون «انزلاق» الصوت تدريجياً بين الجلسات.
وتعد جوجل بميزة رابعة قادمة سمتها Voice Remixing: اختيار صوت من المكتبة ثم ضبط طبقته وإيقاعه ولهجته بتعليمات نصية مثل «أضف لمسة لهجة southern أمريكية خفيفة» أو «خفف حدة الأداء».
أخرج الأداء سطراً بسطر كما تخرج ممثلاً
هنا يكمن الفرق الجوهري عن كل ما سبق. النموذجان لا يستقبلان «نصاً» ويخرجان «قراءة»، بل يقبلان إخراجاً مسرحياً مكتوباً:
- توجيه الأداء سطراً بسطر: تكتب تعليماتك المسرحية بنفسك أو تدع جيميني يستخلصها من سياق النص — من موظف خدمة عملاء هادئ إلى همسة مشهد تشويق.
- مشهد ثنائي المتحدث من نص واحد: حوار كامل بين شخصيتين بصوتين منفصلين وتبادل أدوار طبيعي، من سكريبت واحد — بدون تسجيل كل طرف على حدة ثم المونتاج.
- لمسات محادثة واقعية: وسوم صريحة للانفعالات مثل الضحكة والتنهد والشهقة (
<laughs>و<sigh>و<gasp>) وتفاعلات استماع مثل «مم» و«أيوه» في مواضعها لضبط التوقيت الكوميدي وإيقاع الحوار. - التوليد طويل الأمد: الحفاظ على جودة الصوت وثبات الشخصية عبر ساعات متصلة من الصوت بانحراف شبه معدوم في المتحدث — وهو ما يفتح باب الكتب الصوتية العربية الكاملة من نص واحد.
من الناحية العملية هذا يعني أن صانع البودكاست العربي يستطيع كتابة حلقة حوارية بين «مقدم» و«ضيف افتراضي» وتلقيها مؤداة بالكامل، ثم تعديل نبرة سطر واحد بعينه دون إعادة توليد الحلقة. وهذه بالضبط الفلسفة التي نبني عليها أدواتنا في الكاتب الآلي داخل ARWriter: النص أولاً بأفضل صياغة ممكنة، ثم التوزيع على الوسائط.
ماذا تقول الأرقام عن الجودة؟
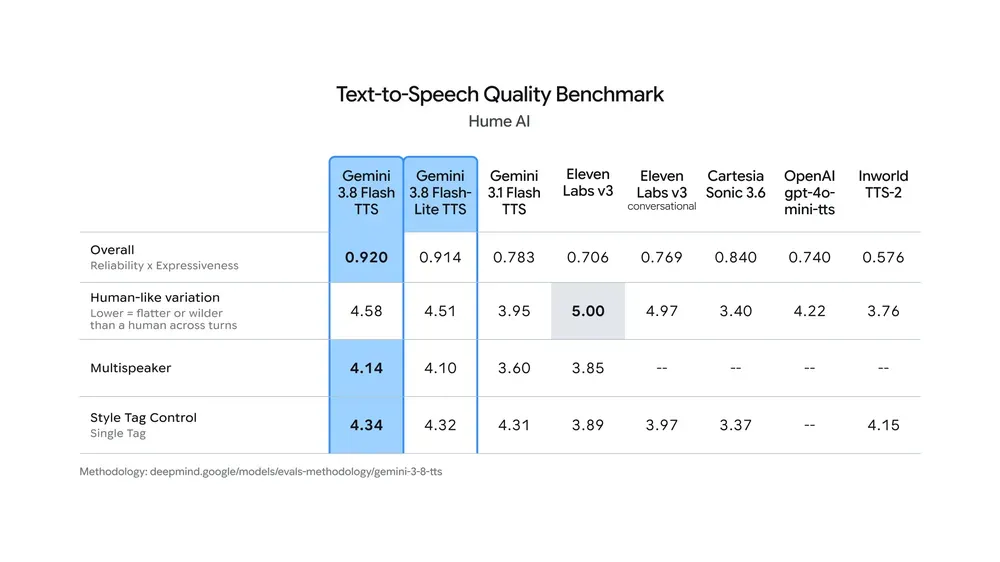
لا يجب أن يُبنى قرار احترافي على الانطباعات، وجوجل تعلم ذلك فنشرت نتائج خارجية موثقة. على معيار Hume AI لتصميم الأصوات حلّ النموذج الرائد في المركز الأول عالمياً بنتيجة 71.4، وحل أولاً كذلك في نمذجة اللكنات بنتيجة 60.8، بينما احتل النموذجان الجديدان المركزين الأول والثاني في مؤشر Hume للجودة الشاملة. وبمقارنة الجيل الحالي بالسابق، تسجل جوجل قفزات واضحة في المحتوى الطويل والتحكم بسيناريوهات المتحدثَين مقارنة بـ Gemini 3.1 Flash TTS.
وهذان الرسمان الرسميان من منشور الإعلان يلخصان موقع النموذجين بين المنافسين في التقييمات البشرية:
الأسعار بالأرقام: كم تكلف الساعة الصوتية فعلاً؟
صفحة الأسعار الرسمية تحدد التسعير لكل مليون توكن، مع أن الثانية الصوتية تعادل 25 توكن — وهذا المفتاح لفهم التكلفة الحقيقية:
| البند | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS | الجيل السابق 3.1 Flash TTS |
|---|---|---|---|
| إدخال النص (لكل مليون توكن) | 0.50$ حتى نهاية 2026 (ثم 1.00$) | 0.50$ حتى نهاية 2026 (ثم 1.00$) | 1.00$ |
| إخراج الصوت (لكل مليون توكن) | 9.00$ حتى نهاية 2026 (ثم 18.00$) | 6.00$ حتى نهاية 2026 | 20.00$ |
| الباقة المجانية | متاحة | متاحة | متاحة |
لنترجم الأرقام إلى لغة المنتج: مليون توكن صوتي تساوي 40 ألف ثانية أي نحو 11.1 ساعة صوت. أي أن نموذج Flash الرائد بسعر 9 دولارات للمليون يكلف فعلياً نحو 81 سنتاً لكل ساعة صوت مولد، ونموذج Lite نحو 54 سنتاً للساعة — بأسعار الترويج الجارية حتى 31 ديسمبر 2026. وبالمقارنة مع الجيل السابق (20$ لكل مليون)، النموذج الرائد الجديد أرخص بنسبة تفوق النصف رغم قفزة الجودة.
تنبيه مهم للتخطيط: الأسعار المعلنة أسعار إطلاق ترتفع في الأول من يناير 2027 (إخراج Flash إلى 18$ للمليون)، فمن يبني حسابات تكلفتك على هذه الأرقام فليضع الضعف في نموذجه الاستشرافي، مع بقاء التكلفة تنافسية بكل المقاييس.
أين تجرب النماذج اليوم؟ خطوات عملية
أسرع طريق للتجربة هو ساحة الصوت الجديدة في Google AI Studio التي وصفها الإعلان بأنها «مساحة عمل لتصميم الأصوات»: تكتب وصف الصوت فتسمعه، تحفظه، ثم تنقله إلى محرر السيناريو ثنائي المتحدث لتخرج الحوار سطراً بسطر. والتجربة فيها تشمل استنساخ صوتك أنت أيضاً.
- افتح aistudio.google.com وابحث عن قسم توليد الكلام أو الأصوات (Speech generation).
- اكتب وصف الشخصية الصوتية بالعربية أو الإنجليزية (نوع الأداء، العمر التقريبي، النبرة، اللهجة) وولد نماذج أولية حتى ترضيك.
- جرّب الإخراج السطري: ألصق فقرة من نصك وأضف تعليمات مثل «بحماس متصاعد» أو «بنبرة خبر هادئة» وقارن.
- للمطورين: نداء واحد إلى الواجهة البرمجية باسم النموذج
gemini-3.8-flash-ttsأوgemini-3.8-flash-lite-ttsيعيد الصوت، وإدارة الأصوات عبر/v1beta/voices.
ولغير المطورين: نموذج Flash الكامل يتدحرج داخل Gemini Notebook، ونموذج Lite داخل Google Vids لتعليق صوتي جاهز على عروضك ومقاطعك دون مغادرة أدوات جوجل. أما إن كنت تدير فريقاً ويهمك الالتزام المؤسسي فالتوفر عبر Gemini Enterprise «قريباً» حرفياً في نص الإعلان.
ولإنتاج مقاطع ريلز وتيك توك العربية الكاملة — من الفكرة إلى النص إلى الجدولة — يبقى سير العمل الأسرع هو تجهيز السكريبت في منصة ARWriter ثم تمريره إلى أي محرك صوتي تختاره، بمن فيه هذا الجديد من جوجل.
مقارنة سريعة: أين يقف أمام خياراتك الحالية؟
الجميع يقارن فوراً بأسماء مثل ElevenLabs أو أصوات OpenAI، لكن المقالات التي تسوق لك «الأفضل» دون سياق مضللة. المقارنة الصحيحة تمر بثلاث نقاط: الجودة العربية الموثقة (وهنا تكسب جوجل بتقييم Voice Arena الصريح للفصحى)، والتكلفة عند الحجم (نحو نصف دولار إلى دولار للساعة بسعر الإطلاق — وهذه منطقة تنافسية جداً)، والاندماج في منظومتك (هنا يتفوق من يعمل أصلاً داخل بيئة جوجل: Vids وNotebook وAI Studio مجاناً للتجربة). أما من يحتاج صوتاً محدداً بصوت فنان معين أو مكتبة عربية بلهجات خليجية/مغربية متعددة فسيظل يجرب البدائل المتخصصة قبل الحسم — والقرار الصحيح عملياً هو اختبار النص نفسك على نموذجين أو ثلاثة والحكم بأذنك.
داخل عائلة جوجل نفسها الصورة أوضح: هذا الإصدار هو «غرفة الصوت» بجودة استوديو، بينما نموذج Gemini 3.8 Live الذي غطيناه سابقاً هو «المحادثة الحية»، ونموذج التفريغ الصوتي غطيناه في مقالنا عن Grok Voice Transcribe 2.0 والتفريغ عموماً. ثلاث أدوات، ثلاث وظائف مختلفة.
حدود وعيوب يجب أن تعرفها قبل الاعتماد الكامل
- التسعير المؤقت: أسعار 2026 أسعار إطلاق ترتفع مطلع 2027 — خطط بمرونة.
- قيود جغرافية على الاستنساخ: استنساخ الأصوات عبر AI Studio غير متاح حالياً في إلينوي وتكساس والمنطقة الاقتصادية الأوروبية والمملكة المتحدة وسويسرا والهند. دول الخليج والمنطقة العربية غير مشمولة بالقيد — وهي نقطة إيجابية لجمهورنا تستحق التوثيق.
- العلامة المائية الدائمة: كل مقطع صوتي يولد يحمل علامة SynthID غير المسموعة المنسوجة في الموجة الصوتية. هذا ممتاز لمصداقيتك عند الإفصاح عن المحتوى المولد، لكنه يعني أيضاً أن استخدام الصوت للتنكر بصوت أشخاص آخرين مسار مغلق تصميمياً — كما ينبغي.
- Voice Remixing لم يصل بعد: ميزة ضبط الصوت الموجود «قريباً» وفق الإعلان، فلا تبنِ عليها في خطتك الفورية.
- البعد المؤسسي: الأحجام المؤسسية بخصائص الامتثال تنتظر توفر الواجهة في Gemini Enterprise.
ماذا يعني هذا لك عملياً؟ ثلاث سير عمل جاهزة
1) صانع الريلز والشورتس: اكتب نص 45 ثانية، ولّد الصوت بـ Lite (تكلفة أقل من سنت)، ثبّته على الفيديو في محررك. صوت عربي فصيح بجودة تعليق احترافي صار بلا ميكروفون وبلا استوديو.
2) الكتاب الصوتي والبودكاست: النموذج الرائد مع المشهد الثنائي والثبات الطويل يعني فصلاً صوتياً كاملاً من نص الفصل مباشرة — بطل وقارئ بشخصيتين صوتيتين محفوظتين تتكرران عبر الفصول بنفس الهوية.
وبين هذه المسارات الثلاثة يبرز نمط مشترك تستحق ملاحظته: الصوت لم يعد مرحلة إنتاج منفصلة تتم بعد كتابة النص، بل صار امتداداً مباشراً للكتابة نفسها؛ فالتعليمات الصوتية (نبرة، انفعال، إيقاع) تُكتب في اللحظة نفسها التي تُكتب فيها الجملة. من يدرب فريقه على كتابة «نص قابل للنطق» بهذا المعنى — جمل قصيرة، وقفات مقصودة، تعليمات أداء مدمجة — سيقطع المسافة من الفكرة إلى النشر في جزء من الزمن الذي تحتاجه الاستوديوهات التقليدية.
3) الدبلجة والتوسع الإقليمي: شركاء جوجل المعلنون في هذا الإصدار أنفسهم يعملون في الدبلجة والتوطين (HeyGen وLinguana وWondercraft وOllang)، وهي إشارة واضحة إلى أن حالة الاستخدام الأولى عالمياً هي نقل المحتوى بين اللغات — ومنها إلى العربية وبالعكس. من يملك محتوى عربياً جاهزاً أمامه اليوم أرخص آلية دبلجة عرفها السوق.
الخلاصة: جفون التنافس الصوتي انفتحت للعربية
بين ليلة وضحاها صار للعربية الفصحى نموذج صوتي يتصدر تقييمات بشرية عمياء، وبتكلفة تقارب الدولار للساعة الكاملة، وداخل أدوات مجانية التجربة. المنافسة ستشتد حتماً وسترد بقية اللاعبين — وهذا في مصلحة صانع المحتوى العربي قبل أي أحد. ابدأ اليوم بتجربة مجانية في AI Studio على نص من عندك، وقس النتيجة بأذنك أنت لا بعناوين الإعلانات؛ وحين تجهز سكريبتاتك، جرّب توليد وبنية الحلقة كاملة من أدوات الكتابة في ARWriter — من الفكرة إلى النص الجاهز للقراءة الآلية، وكل ذلك بالعربية أولاً.
المصادر الرسمية
- إعلان جوجل الرسمي: Gemini 3.8 text-to-speech says hello (مدونة جوجل، 23 سبتمبر 2026)
- سجل إصدارات Gemini API — التوفر العام للنموذجين (22 سبتمبر 2026)
- صفحة الأسعار الرسمية لـ Gemini API
- توثيق توليد الكلام وجدول اللغات — يشمل العربية الفصحى والعربية المصرية
- بطاقة نموذج Gemini 3.8 Audio (Google DeepMind)
تاريخ الحدث المُوثق: الإتاحة العامة 22 سبتمبر 2026 ومنشور الإعلان 23 سبتمبر 2026. هذا المقال دليل تحليلي لحدث أُعلن قبل أيام، وليس خبراً عاجلاً.
أسئلة شائعة
هل يدعم Gemini 3.8 Flash TTS اللغة العربية فعلاً؟
نعم. وثائق جوجل الرسمية تسرد العربية الفصحى والعربية المصرية ضمن اللغات المدعومة، وإعلان الشركة يذكر صراحة أن النموذجين حققا مواقع ريادية في تقييمات التفضيل العمياء على Voice Arena في العربية الفصحى الحديثة تحديداً بين لغات عالمية رئيسية أخرى.
هل Gemini 3.8 Flash TTS مجاني؟
توجد باقة مجانية للتجرية عبر Google AI Studio وواجهة Gemini API بحدود الاستخدام المجاني المعتادة، بينما التسعير المدفوع يبدأ من 0.50 دولار لكل مليون توكن نصي و6 إلى 9 دولارات لكل مليون توكن صوتي حتى نهاية 2026.
كم تبلغ تكلفة تحويل كتاب أو مقال طويل إلى صوت؟
بما أن الثانية الصوتية تستهلك 25 توكناً، فإن كل مليون توكن صوتي تعادل نحو 11 ساعة صوت؛ أي أن الساعة الواحدة تكلف تقريباً 54 سنتاً بنموذج Lite و81 سنتاً بالنموذج الرائد بأسعار الإطلاق حتى 31 ديسمبر 2026.
هل يمكنني استنساخ صوتي الشخصي بالعربية؟
نعم عبر ميزة Voice Replication بتسجيل 30 ثانية من صوتك مع تسجيل موافقة صوتية يتطلب النظام تطابقه مع الصوت المرجعي. الميزة متاحة في Google AI Studio وتستثني حالياً عدة ولايات ودول أوروبية والهند، دون أي قيد على دول الخليج والمنطقة العربية.
ما الفرق بين Gemini 3.8 Flash TTS وGemini 3.8 Live؟
الأول نموذج تحويل نص إلى كلام مصمم لإنتاج المحتوى المسجل كالبودكاست والكتب الصوتية والدبلجة، بينما الثاني نموذج محادثة صوتية حية ثنائي الاتجاه يسمعك ويرد فوراً؛ كلاهما من عائلة Gemini Audio لكن لكل منهما وظيفة مختلفة تماماً.