آخر تحديث: أكتوبر 2026
زيارات الذكاء الاصطناعي هي الزوار الذين يصلون موقعك بعد نقرة على رابط داخل إجابة من مساعد ذكي مثل ChatGPT أو Claude أو Perplexity، وتظهر في تحليلاتك كمصدر إحالة مستقل تماماً عن بحث جوجل. دراسة SE Ranking لـ 101,574 موقعاً وجدت أن حصة هذه الزيارات ارتفعت من 0.02% عام 2024 إلى 0.32% عام 2026، أي تضاعفت 16 مرة في عامين.
المشكلة أن أغلب المسوّقين العرب يتعاملون مع هذا النوع من الزيارات من زاويتين خاطئتين: إما التجاهل التام بحجة أن النسب صغيرة، أو ترديد نصائح «الظهور في الذكاء الاصطناعي» العامة دون قياس نتيجة واحدة على أرض الواقع. النتيجة في الحالتين واحدة: مدونة أو متجر سلة أو زد يتلقى زيارات شهرية من ChatGPT منذ أشهر دون أن يعرف صاحبه بوجودها أصلاً، لأنها مدفونة داخل تقرير «الإحالات» في GA4.
هذا المقال يعالج الجزء المفقود تحديداً: كم زائراً يرسل الذكاء الاصطناعي فعلاً بأرقام موثقة، كيف تضبط القياس في 30 دقيقة، لماذا يقتبس Claude مصدراً ويتجاهل آخر، وهل المحتوى العربي يدخل المنافسة أصلاً — ثم نظام كتابة يجعل فقراتك مرشحة للاقتباس. وإن كان اهتمامك بالجزء الخاص بجوجل نفسها وبحثها الذكي، فله دليل منفصل: الظهور في Gemini ووضع البحث الذكي.
كم زائراً يرسل الذكاء الاصطناعي فعلاً؟ الأرقام قبل الوعود
الزيارات القادمة من المساعدين الأذكياء ما زالت صغيرة كنسبة، لكنها أسرع قنوات النمو في التحليلات اليوم، ومن يبني حضوره الآن يستفيد قبل ازدحام السوق العربي. دراسة SE Ranking المنشورة في يونيو 2026 راقبت 101,574 موقعاً في 250 دولة على مدى 16 شهراً، فوجدت أن واحدة من كل 312 زيارة تأتي اليوم من مساعد ذكي، بينما لا تزال زيارات البحث المجاني تشكل 42.75% من الإجمالي — أي أن القناة الجديدة مكملة ولا تلغي جوجل.
قبل أي قرار، إليك توزيع هذه الزيارات على المحركات كما رصدتها الدراسة نفسها:
| المحرك | حصة زيارات الذكاء الاصطناعي 2026 | ملاحظة |
|---|---|---|
| ChatGPT | 74.78% | كانت 79.74% في 2025 — يتراجع لصالح المنافسين |
| Gemini | 11.56% | أسرع الصاعدين داخل قائمة جوجل |
| Perplexity | 7.23% | الأثقل اعتماداً على المصادر المجتمعية |
| Copilot | 3.51% | مدعوم بتواجد مايكروسوفت في المتصفح |
| Claude | 2.62% | الأصغر حصة والأسرع نمواً كما سترى |
الرقم الذي يستحق انتباهك ليس حصة ChatGPT بل قصة Claude: نمو 320% في عام واحد (من 0.0021% إلى 0.0084% من إجمالي الزيارات)، وشهر مارس 2026 وحده سجل قفزة 159%. وتضيف بيانات BrightEdge الصادرة في سبتمبر 2026 أن إجمالي الزيارات المحالة من منصات الذكاء الاصطناعي نما 73% في أقل من سنة، وأن إحالات ChatGPT تضاعفت 101% بين يناير وأغسطس 2026. القناة تسير في اتجاه واحد.
وهنا نقطة يخطئ فيها حتى المحترفون. ستجد دراسة تقول إن حصة ChatGPT 74.78% وأخرى تقول 95.1% — والاثنتان صحيحتان. الفرق في العينة: SE Ranking تقيس شبكة مواقع صغيرة ومتوسطة الغالبية (101 ألف موقع)، بينما BrightEdge تقيس مواقع عملائها من الشركات الكبرى التي يزورها جمهور أمريكي مبكر في تبنّي ChatGPT، فوصولها لذروة 95.1% في أغسطس 2026 طبيعي. الخلاصة العملية: موقعك عربي صغير أو متوسط؟ توقع سلوكاً أقرب لأرقام SE Ranking، واعتبر أرقام BrightEdge سقف الاتجاه لا رقمك أنت.
ماذا تعني نسبة 0.32% لموقعك أنت؟ الحسبة قبل الحلم
النسب المئوية الصغيرة لا تعني شيئاً حتى تُحوَّل إلى أرقام زيارات فعلية على موقعك، والحسبة أبسط مما تظن: اضرب زياراتك الشهرية في 0.0032، ثم طبّق معدل نمو 4.7% شهرياً (وهو اشتقاق النمو السنوي 73% الذي رصدته BrightEdge) لتقرأ مسار السنة القادمة. من يملك 30 ألف زيارة شهرياً يستقبل اليوم نحو 96 زائراً شهرياً من المساعدين، وسيصل إلى 159 زائراً في الشهر الثاني عشر لو بقي محتواه كما هو دون أي تحسين.
إليك النموذج مطبقاً على ثلاثة أحجام شائعة من المواقع العربية:
| حجم الموقع (زيارات/شهر) | الشهر 1 | الشهر 6 | الشهر 12 |
|---|---|---|---|
| متجر سلة ناشئ — 5,000 | 16 زائراً | 20 زائراً | 27 زائراً |
| مدونة محتوى نشطة — 30,000 | 96 زائراً | 121 زائراً | 159 زائراً |
| متجر أو موقع إخباري — 120,000 | 384 زائراً | 483 زائراً | 635 زائراً |
الرقم الأهم يأتي بعد الجدول: هؤلاء ليسوا زواراً عاديين. نفس دراسة SE Ranking وجدت أن زائر الذكاء الاصطناعي يمكث في الموقع 67.7% وقتاً أطول من زائر البحث المجاني — 9 دقائق و19 ثانية مقابل 5 دقائق و33 ثانية (والوسيط: 2:24 مقابل 1:53). عملياً، كل زيارة من ChatGPT تساوي نحو 1.7 زيارة عضوية من حيث دقائق القراءة، فلتحسب جدولك بهذا المعامل قبل الحكم على حجم القناة.
نظام قياس في 30 دقيقة: من GA4 إلى سجلات السيرفر
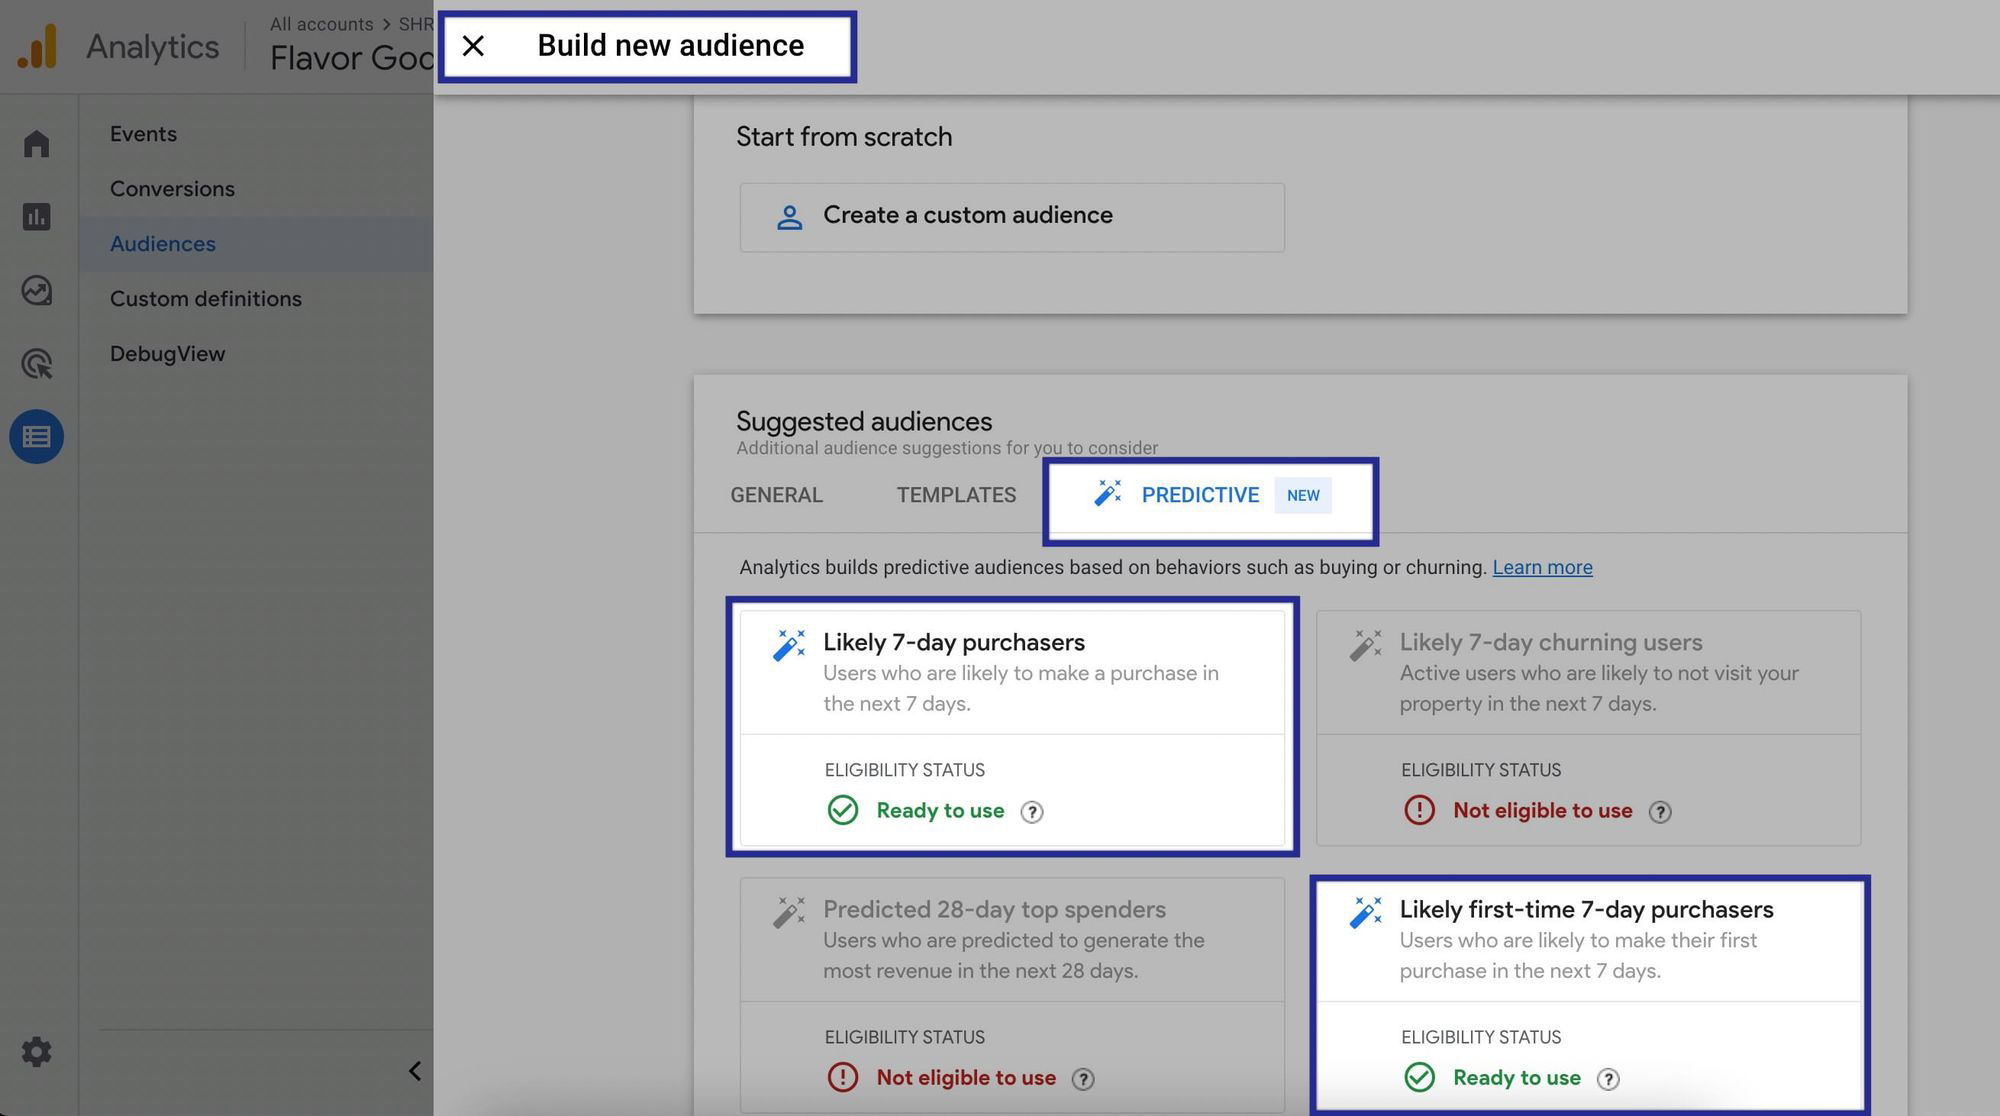
القياس الصحيح يبدأ من مشكلة واحدة: GA4 في إعداده الافتراضية يدفن زيارات ChatGPT وClaude داخل قناة «الإحالات» العامة، فتختلط بمواقع منتديات ووكلاء آخرين، والحل هو مجموعة قنوات مخصصة واحدة تفرزها خلال نصف ساعة. الروابط الخارجة من ChatGPT تحمل تلقائياً وسم utm_source=chatgpt.com، وهذا يعني أن بياناتك موجودة أصلاً — فقط لا أحد يصنّفها.
خطوات الإعداد كاملة:
- افتح GA4 ثم الإدارة ← إعدادات البيانات ← مجموعات القنوات (Admin ← Data settings ← Channel groups).
- أنشئ مجموعة قنوات جديدة وسمِّها «المساعدون الأذكياء».
- أضف شرطاً واحداً: مصدر الجلسة يطابق التعبير النمطي التالي (انسخه كما هو):
chatgpt\.com|claude\.ai|perplexity\.ai|gemini\.google\.com|copilot\.microsoft\.com
- احفظ، ثم انتبه لمصيدة الترتيب: GA4 يطبّق قواعد مجموعتك المخصصة قبل القنوات الافتراضية، وأول قاعدة تتطابق تفوز — لذا أبقِ قاعدة المساعدين أعلى القائمة كي لا تُبتلع مرة أخرى داخل «الإحالات».
- انتقل إلى تقارير ← الاستحواذ ← استحواذ الزيارات، وبدّل عرض «مصدر الجلسة» لترى كل محرك على حدة.
- أنشئ مقارنة محفوظة (Compare) بمصدر الجلسة نفسه، لتتابع التغير شهرياً بنقرة واحدة.
ولأن الإحالات وحدها لا تصنع قراراً، أضف الطبقة الثانية: فحص سجلات السيرفر. الاقتباس في إجابة المحرك يسبقه دائماً زحف روبوت قراءة، فمقارنة أيام الزحف بأيام ظهور الإحالات تخبرك أي الصفحات «تُقرأ» فعلاً. على سيرفر nginx مثلاً:
grep -iE "ClaudeBot|GPTBot|GPTBot-User|PerplexityBot" /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c
ثم ارجع إلى GA4 في الأيام التالية مباشرة. زحف كثيف بلا إحالات؟ محتواك يُقرأ ولا يُقتبس — وهذا تشخيص ثمين سنحله في أقسام الكتابة لاحقاً. ولمتابعة أعمق في تعريف المصادر داخل التقارير، أعدنا شرح تفاصيل الفلترة في دليل قياس زيارات الذكاء الاصطناعي في GA4.
ثلاث آلات اقتباس: كيف يختار Claude وChatGPT وPerplexity مصادرها؟
كل محرك يبني إجابته بطريقة مختلفة تماماً، فما يجعل Claude يقتبسك يختلف عما يجعل Perplexity تفعل، وتحسين الصفحة لمحرك واحد لا ينقلها تلقائياً للبقية. بيانات Discovered Labs المنشورة في يناير 2026 وجدت أن نحو 11% فقط من المواقع التي تقتبسها ChatGPT تتقاطع مع مواقع Perplexity — أي أن الساحتين شبه منفصلتين، وهذه فرصة لمن يفهم الفرق.
أولاً Claude: وثائق أنثروبيك الرسمية توضح أن أداة البحث تعمل من جانب الخادم، وأن Claude يقرر البحث فقط حين يقدّر أن المعلومات متغيرة أو حديثة أو ناقصة من معرفته — أما الحقائق الثابتة القديمة فيجيب عنها دون بحث أصلاً. النقطة الحاسمة: الاقتباس يعود كنص محدد بحد أقصى نحو 150 حرفاً، ما يعني أن أول سطرين من فقرتك هما مرشحاك الوحيدان للاقتباس. والمطور الذي يبني تطبيقاً على Claude يمكنه حصر البحث في نطاقات مسموحة أو محظورة، فظهورك في تطبيق واحد لا يعني ظهورك في الجميع.
ثانياً ChatGPT: يتصفح الويب عند الحاجة، ثم يركّب الإجابة مع إشارات مصادر مدمجة في النص ولوحة مصادر جانبية ينقر منها المستخدم، والنقرة تصل موقعك موسومة بالمصدر chatgpt.com — وهذا بالضبط ما رصدناه في خطوات GA4 أعلاه. ثالثاً Perplexity: تجمع إجاباتها لحظياً من مصادر حية، مع ميل واضح للمصادر المجتمعية؛ Reddit وحده يشكل 46.7% من مصادرها العليا مقابل نحو 12% لدى ChatGPT (وويكيبيديا 7.8% تقريباً).
| ماذا يكافئ كل محرك | Claude | ChatGPT | Perplexity |
|---|---|---|---|
| متى يبحث | معلومات متغيرة أو ناقصة فقط | عند طلب المستخدم التصفح | دائماً، لحظياً |
| عمق البحث النمطي | 1-3 عمليات، وتتجاوز 10 للمقارنات | تصفح حسب الحاجة | استرجاع فوري مستمر |
| شكل الاقتباس | نص محدد حتى 150 حرفاً تقريباً | إشارة داخلية + لوحة مصادر | رقم مصدر لكل جملة |
| المصدر المجتمعي الأثقل | تأثيره محدود | Reddit نحو 12% | Reddit 46.7% |
| أقوى رافعة عربية | فقرة افتتاحية قابلة للاقتباس | توثيق وحداثة المعلومات | حضور في Reddit والمجتمعات |
الاستنتاج العملي من الجدول: لا يوجد «تحسين للذكاء الاصطناعي» واحداً بل ثلاثة، وإن كنت ستبدئ بواحد فابدأ بفقرات Claude القابلة للاقتباس لأنها تبني أصلاً يخدم المحركين الآخرين معاً. وإن أردت التعمق في عقل المحرك الأول تحديداً، اقرأ تحليلنا لأحدث إصداراته في دليل Claude Opus 5.5 للسيو والدليل الشامل عن Claude.
هل يُقتبس المحتوى العربي أصلاً؟ واقع المنطقة وخطة الدخول
نعم يُقتبس، لكن بشرط: المحركات تسترجع من الويب الحي وقت السؤال، فحين يكون أفضل مصدر لسؤال عربي مكتوباً بالإنجليزية، ستقتبسه المحركات حتى لو كان السائل عربياً — وهذه هي الفجوة التي تجعل المنافسة العربية مفتوحة بعد. أغلب الأسئلة العربية المتخصصة ما زالت تفتقر لصفحة عربية جيدة تجيب عنها، فمن يكتبها أولاً بالطريقة الصحيحة يجد نفسه المصدر شبه الوحيد المتاح للاقتباس.
خطة الدخول العملية تتكون من أربع خطوات:
- اطرح أسئلة عربية حقيقية كعناوين: عنوان مثل «كم تكلفة إنشاء متجر إلكتروني في السعودية 2026؟» يجذب اقتباساً مباشراً أكثر من عنوان عام مثل «دليل المتاجر الإلكترونية الشامل».
- اربط المصطلحين في نصك: اكتب «تحسين محركات التوليد (GEO)» مرة كاملة ثم استخدم «الظهور في الذكاء الاصطناعي»، فالمحرك يتعرف على المعنى عبر صيغتيه معاً.
- اجعل نسختك العربية قابلة للزحف: لا تحبس المحتوى خلف جافاسكربت أو نافذة تسجيل، واستخدم الأرقام الغربية 0-9 داخل النص العربي لأنها الأوضح في الاقتباس.
- اربط نسختي الموقع بلغة hreflang إن كان لديك محتوى عربي وإنجليزي، حتى يفهم المحرك أي نسخة يجيب عن أي سؤال.
للأمانة: حتى الآن، ميل المحركات للمصادر الإنجليزية في الأسئلة التقنية أقوى من ميلها للعربي، لكن هذا الميل يتقلص كلما زاد المحتوى العربي الجاهز للاقتباس. وإن أردت البدء من أساسيات الظهور في إجابات ChatGPT نفسها، فلدينا مدخل مبسط في دليل الظهور في إجابات بحث ChatGPT.
بالمناسبة، إذا كنت تبحث عن إنتاج محتوى عربي مهيأ ليُقتبس، منصة ArWriter توفر محرراً ومكتبة أوامر بالعربية كاملة.
نظام الفقرة القابلة للاقتباس: كيف تعيد كتابة أقسامك ليُقتبس منها؟
الفقرة القابلة للاقتباس وصفة مكوناتها معروفة: إجابة مكتملة في 40-60 كلمة تفتتح كل قسم، يليها مباشرة رقم موثق بمصدره، ثم قائمة نقطية تفصّل الخطوات — وهذا التركيب بالذات لأن بيانات Discovered Labs وجدت أن المحتوى النقطي أكثر عرضة لاقتباس Claude بنحو 30%، ولأن أول 150 حرفاً من فقرتك هي الحد الأقصى الذي يعود في اقتباس Claude كما رأينا. البحث الأكاديمي المؤسس لهذا المجال (ورقة GEO في مؤتمر KDD عام 2024، arXiv 2311.09735) قاس تحسناً في الظهور يصل إلى 40% عند إضافة الاقتباسات والأرقام والإحصاءات إلى النص، وهو أساس المنهج لا رقم لحظتك الحالية.
طبّق ذلك على 5 صفحات من موقعك ذات أعلى زيارات بحث، بالخطوات التالية:
- افتح كل قسم بعنوان سؤال ثم جملة جوهرية واحدة تصلح إجابة مستقلة لو قُطعت عن المقال.
- اكسر كل فقرة تتجاوز 4 أسطر إلى قائمة نقطية، فالمحرك يفضل البنية القابلة للتقطيع.
- أدرج رقماً بمصدره في كل قسم: «وجدت دراسة SE Ranking لـ 101,574 موقعاً أن...» أفضل مئة مرة من «تشير الدراسات إلى».
- احذف المقدمات الإنشائية من منتصف المقال؛ هي أول ما يُستبعد عند تكثيف الإجابة.
- حدّث التواريخ والأرقام كل 3 أشهر، لأن Claude يبحث تحديداً حين يشك في حداثة المعلومة.
قائمة الفحص قبل النشر، بند واحد لكل سطر:
- هل أول جملتين من كل قسم تصلحان إجابة مستقلة؟
- هل يوجد رقم بمصدره في كل قسم رئيسي؟
- هل العناوين الرئيسية صياغات أسئلة يكتبها جمهورك فعلاً؟
- هل الأرقام كلها بالصيغة الغربية من 0 إلى 9 دون استثناء؟
- هل يوجد مصدر خارجي موثوق واحد على الأقل في المقال؟
- هل تعمل الصفحة بسرعة، فزمن أول رسم تحت 0.4 ثانية ربطته البيانات بمتوسط 6.7 اقتباسات مقابل 2.1؟
- هل النص متاح للزحف دون تسجيل أو حجب جافاسكربت؟
- هل وضعت قائمة نقطية بعد كل شرح نظري؟
- هل حدّثت سطر «آخر تحديث» في أعلى الصفحة؟
- هل ملف robots.txt يسمح لروبوتات القراءة كما سنرى بعد قليل؟
الجزء الأصعب ليس الكتابة بل الاستمرار: إنتاج صفحات بهذا المعياري أسبوعياً يتطلب خط إنتاج لا حماسة أسبوع. لهذا شرحنا بناء خط إنتاج كامل للمحتوى في دليل بناء خط محتوى الذكاء الاصطناعي.
من الرياض إلى لوحة GA4: قصة أحمد مع أول 64 زائراً
أحمد، مسوّق محتوى مستقل من الرياض، يدير مدونة تقنية مصرية تتجاوز زياراتها 20 ألف زيارة شهرياً. حين قرأ عن حصة المساعدين الأذكياء طبّق الحسبة فوراً: 20,000 ضرب 0.0032 تساوي 64 زائراً متوقعاً شهرياً. فتح GA4 باحثاً عن «زيارات من ChatGPT» فلم يجد شيئاً بالاسم — المشكلة الأولى التي يقع فيها الجميع: الأرقام كانت موجودة لكنها مبعثرة داخل تقرير الإحالات بلا تصنيف.
أنشأ مجموعة القنوات المخصصة بالخطوات السابقة، ونزل التقرير مجدداً بعد ساعة: 41 زيارة من chatgpt.com و7 من claude.ai و5 من perplexity.ai خلال 30 يوماً — مجموعها 53 زائراً كانوا يصلون شهرياً دون أن يعلم أحد. تدقيق سريع في سلوكهم أظهر متوسط جلوس يتجاوز 8 دقائق، وهو ما حوّل قناعته من «قناة هامشية» إلى «قناة جودة عالية مهملة».
ثم بدأ العمل الحقيقي: أعاد كتابة 6 أقسام في 4 مقالات بفقرات افتتاحية قابلة للاقتباس، وأضاف رقمين موثقين لكل مقال، وحوّل فقرتين وصفتين إلى قوائم نقطية، وسمح لروبوتات القراءة في ملف robots.txt، وأنشأ حساباً على Reddit يجيب فيه عن أسئلة الأدوات التي يراجعها. في نهاية الشهر الثالث وصل مجموع الزيارات من المساعدين إلى 191 زيارة شهرياً، ودخلت مقالتان له ضمن مصادر Perplexity لسؤال عربي متخصص ظل محتكراً لموقعين إنجليزيين. الدرس الذي لخّصه أحمد لنفسه: القياس أولاً، فبدون لوحة GA4 المضبوطة كان سيمضي سنة كاملة يسمع عن «عصر الذكاء الاصطناعي» وهو يستقبل مئات الزوار منه دون أن يعرف.
ملف llms.txt: ماذا يفعل فعلاً وماذا لا يفعل؟
ملف llms.txt هو اقتراح مواصفة نشره جيريمي هوارد من Answer.AI في سبتمبر 2024 وحدّثته نسخته الثانية في أغسطس 2026: ملف بصيغة ماركداون في جذر موقعك يعرّف بالمحتوى ويقسمه، لكن مواصفته نفسها لا تعد بأي ظهور أو اقتباس — فهو يُستخدم عند الطلب فقط حين يحتاج وكيل ذكي معلومة، وليس إشارة ترتيب يقرؤها المحرك مسبقاً. الانتشار حقيقي: بيانات OtterlyAI المنشورة عبر aidev.com وجدته على 10.13% من النطاقات، ومنصات مثل Wix وGitHub Docs تدعمه أو تولّده تلقائياً، وحتى OpenAI وأنثروبيك وجوجل تنشره لوثائقها الخاصة — وهذا بالضبط استخدامه الصحيح.
شكله أبسط مما تتخيل:
# اسم موقعك
> سطر يلخص ما يقدمه الموقع ولمن

## الوثائق
- [دليل الاستخدام](https://example.com/guide.md): وصف مختصر
- [الأسئلة الشائعة](https://example.com/faq.md): وصف مختصر
الحكم الصريح: انشر الملف لتوثيق منتجك وصفحاته الداعمة لأن الوكلاء قد تستفيد منه فعلاً، ولا تتوقّع أن يرفع من فرص اقتباسك في ChatGPT أو Claude — فهذا ليس وظيفته أصلاً، وجوجل لا تعتمده. الرافعة الأهم تقع قبله بخطوة: تأكد أن ملف robots.txt لا يحجب روبوتات القراءة، فالمقتبَس يجب أن يكون مقروءاً أولاً:
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /
افحص الملف الآن، فبعض القوالب والضافات الأمنية تحجب عناكب غير معروفة افتراضياً دون أن تنتبه.
أسئلة يسألها كل مسوّق عربي قبل البدء
ما الفرق بين GEO وSEO؟
السيو (SEO) يهتم بترتيبك في نتائج بحث جوجل التقليدية، بينما GEO (تحسين محركات التوليد) يهتم بظهورك واقتباسك داخل الإجابات التي يركّبها الذكاء الاصطناعي. الاثنان يتشاركان الأساسيات: محتوى موثوق وسريع ومنظم. الفرق في المعيار: جوجل تكافئ الروابط وسلوك النقر، والمحركات التوليدية تكافئ الإجابات المكتملة والأرقام الموثقة والبنية القابلة للتقطيع.
كيف أقيس زيارات ChatGPT في Google Analytics خطوة بخطوة؟
افتح الإدارة ← إعدادات البيانات ← مجموعات القنوات في GA4، أنشئ مجموعة جديدة باسم «المساعدون الأذكياء»، وأضف شرط أن يطابق مصدر الجلسة التعبير chatgpt.com|claude.ai|perplexity.ai|gemini.google.com|copilot.microsoft.com ثم احفظ. بعدها ستظهر الزيارات مفروزة في تقرير الاستحواذ. الرابط الخارج من ChatGPT يحمل utm_source=chatgpt.com أصلاً، فلا تحتاج أي إعداد إضافي على موقعك.
هل زيارات الذكاء الاصطناعي زوار حقيقيون أم بوتات؟
زوار حقيقيون في أغلبهم: البوتات تزحف موقعك مباشرة وتظهر في سجلات السيرفر بأسماء مثل GPTBot وClaudeBot، أما زيارات GA4 فتحدث عندما ينقر إنسان على رابط داخل محادثته. الدليل الأقوى سلوكي: دراسة SE Ranking وجدت أن زائر المساعد الذكي يمكث 9 دقائق و19 ثانية في المتوسط، أي 67.7% أطول من زائر البحث المجاني — وهذا سلوك قارئ مهتم لا برنامج.
كيف يختار Claude المصادر التي يقتبسها في إجاباته؟
وفق وثائق أنثروبيك، يبحث Claude فقط حين يقدّر أن المعلومات متغيرة أو حديثة أو ناقصة من معرفته، فيجري 1-3 عمليات بحث للموضوع الواحد وتتجاوز 10 للمقارنات. يعود الاقتباس كنص محدد بحد أقصى نحو 150 حرفاً، لذا فقرتك الافتتاحية هي المرشح. والمطور يمكنه حصر البحث في نطاقات محددة، فالظهور في تطبيق مبنى على Claude لا يعني الظهور في كل تطبيقاته.
هل يجب السماح لروبوت GPTBot حتى يظهر موقعي في ChatGPT؟
نعم، فهذه شرط أساسي لا تحسين اختياري: GPTBot هو روبوت القراءة الذي يبني فهم ChatGPT لصفحاتك، وحجبه في robots.txt يعني حرمان النموذج من محتواك أساساً. أضف أسطر السماح لـ GPTBot وClaudeBot وPerplexityBot كما في المثال أعلاه، وتأكد أن إضافة أمن أو قالب لم تحجب العناكب المجهولة افتراضياً. السماح للروبوت لا يرسل زيارات بحد ذاته — هو يفتح الباب فقط.
هل ملف llms.txt ضروري للظهور في إجابات الذكاء الاصطناعي؟
لا، ليس ضرورياً. مواصفة llms.txt نفسها بنسختها الثانية (أغسطس 2026) لا تعد بأي ظهور أو اقتباس، بل تصف استخداماً عند الطلب من الوكلاء، وجوجل لا تعتمده. أنشئه لتوثيق منتجك وصفحاتك الداعمة لأنه مفيد هناك، ولا تعتبره بديلاً عن المحتوى القابل للاقتباس. ما يؤثر فعلاً: جودة الفقرات الافتتاحية، الأرقام الموثقة، وسرعة الصفحة.
هل يظهر المحتوى العربي في إجابات ChatGPT وClaude فعلاً؟
يظهر لكن في مساحة أضيق من الإنجليزية حتى الآن، لأن المحركات تسترجع من الويب الحي و أفضل المصادر المتاحة كثير منها إنجليزي. الحل ليس الانتظار بل ملء الفراغ: أسئلة عربية حقيقية كعناوين، أرقام غربية واضحة، محتوى متاح للزحف، وربط النسختين اللغويتين بـ hreflang. الأسئلة العربية المتخصصة ما زالت تنقصها صفحات عربية جيدة، وهذه فجوة دخول ما زالت مفتوحة.
كم تبلغ حصة الذكاء الاصطناعي من زيارات المواقع في 2026؟
0.32% من إجمالي زيارات المواقع وفق دراسة SE Ranking لـ 101,574 موقعاً منشورة في يونيو 2026، مرتفعة من 0.24% في 2025 و0.02% في 2024 — أي واحدة من كل 312 زيارة. التوزيع: ChatGPT 74.78%، ثم Gemini 11.56%، وPerplexity 7.23%، وCopilot 3.51%، وClaude 2.62% وهو الأسرع نمواً بزيادة 320% في عام واحد.
من أين تبدأ غداً صباحاً؟
ابدأ من القياس لا من النشر، فهو الجزء الذي يحوّل الموضوع من حماس إلى أرقام. خصص أول 30 دقيقة صباحك لمجموعة قنوات GA4 بالخطوات أعلاه، ثم افتح تقرير الإحالات القديم واسحب آخر 90 يوماً — ستعرف فوراً كم زائراً كان يصلك من ChatGPT وأنت لا تدري. في الأسبوع نفسه، افحص robots.txt وأنشئ llms.txt لوثائق منتجك، فهما أرخص خطوتين في المقال كله.
الأسبوعان التاليان للكتابة: اختر 5 صفحات من الأعلى زيارة وأعد بناء افتتاحيات أقسامها بنظام الفقرة القابلة للاقتباس، مع رقم موثق في كل قسم وقائمة نقطية بعد كل شرح. ثم كرر بصبر شهري، فقناة تنمو 73% سنوياً تكافئ من يدخلها مبكراً ويثبت. وإن أردت خارطة أشمل تجمع هذه القناة مع بقية تحضيراتك للبحث الذكي، اقرأ خطة السيو الجاهزة لعصر الذكاء الاصطناعي.
وإن كنت تريد اختصار الطريق على فريقك، فمنصة ArWriter تكتب معك محتوى عربياً بهذا المعياري بالضبط: فقرات جاهزة للاقتباس، أرقام موثقة، وبنية يحبها كل من Claude وChatGPT وPerplexity.
المصادر
- دراسة SE Ranking لحركة زيارات الذكاء الاصطناعي — تحليل 101,574 موقعاً على مدى 16 شهراً، مصدر حصص 2026 وأرقام التفاعل.
- بيان BrightEdge عن تضاعف إحالات ChatGPT — بيانات سبتمبر 2026 عن نمو 73% ونصيب المحركات.
- وثائق أداة البحث في Claude من أنثروبيك — المصدر الرسمي لآلية اختيار المصادر وحدود نص الاقتباس.
- مواصفة llms.txt النسخة الثانية — النص الأصلي للمواصفة وجيريمي هوارد، محدث في أغسطس 2026.
- ورقة GEO في مؤتمر KDD 2024 — الأساس البحثي لتحسين المحتوى التوليدي وقياس تحسن الظهور حتى 40%.
اعتمادات الصور: الصورة البارزة من صفحة Claude الرسمية (Anthropic)، وصورة المطورين من بوابة OpenAI الرسمية. لقطة Google Analytics 4 عبر Wikimedia Commons (CC BY-SA 4.0).